中转 API 报错速查:sse stream ended without [DONE] 等
搜状态码常常搜不到自己那一种——400 底下藏着十几个完全不同的问题。报错正文里的那句英文才有区分度。这一页按报错原文组织,用 Ctrl+F 把你屏幕上那句话贴进来就能跳到对应小节。
按原文查,比按状态码查快
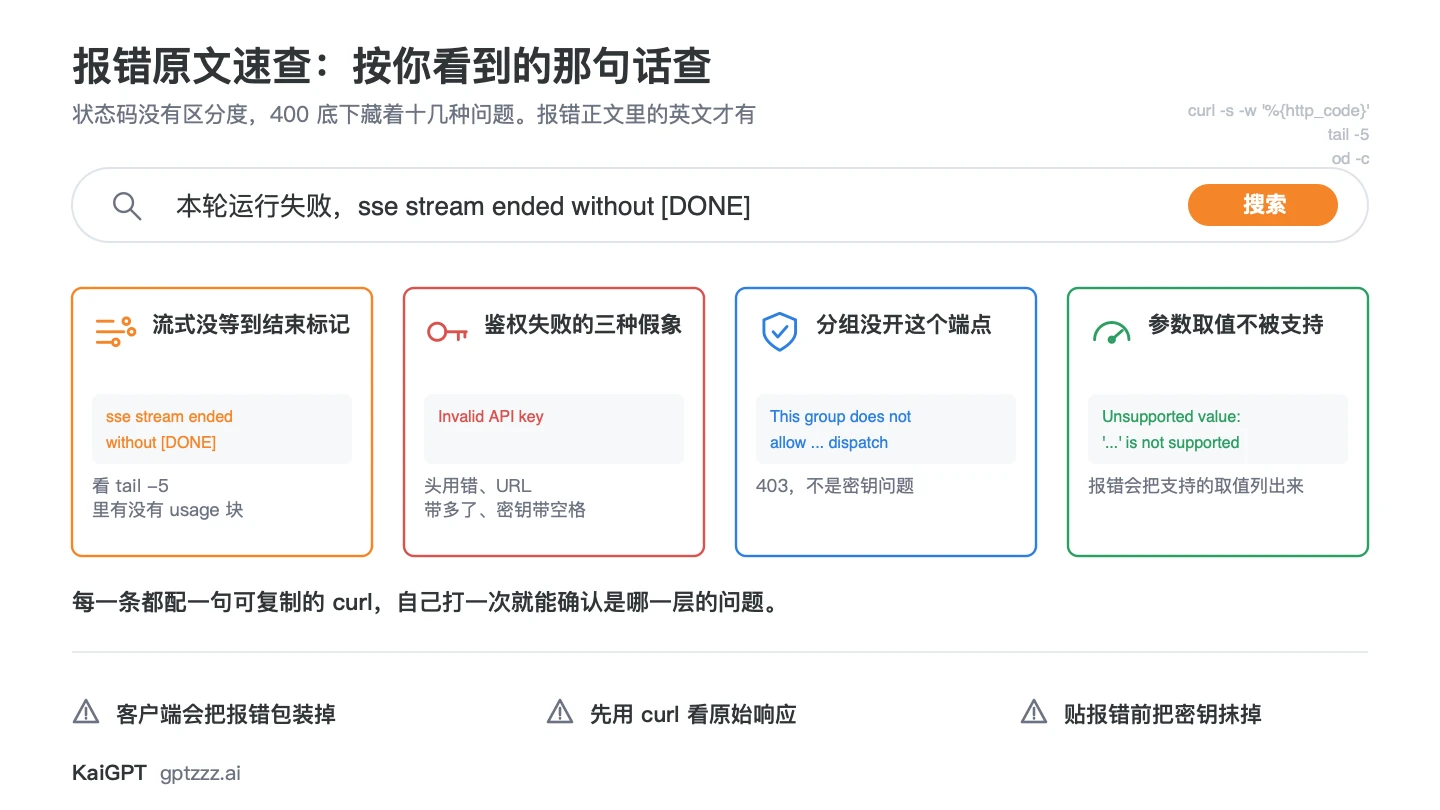
遇到报错时,多数人第一反应是搜状态码。但 400 这个数字底下能藏十几种完全不同的问题,搜出来的结果十有八九不是你那一种。
报错正文里的那句英文才是有区分度的。 它通常直接点名了是哪一层、哪个参数、哪个端点出的问题。所以这一页按你屏幕上看到的那句话组织,每一节的标题就是一条报错原文。
用浏览器的页内查找(Ctrl+F / Cmd+F)把你那句话贴进去,直接跳到对应小节。
如果你手上只有状态码没有正文,那篇按码分层的文章更合适:API 中转站错误码:400、401、404、422、429 与 5xx 排查。
sse stream ended without [DONE]
完整的报错通常长这样:本轮运行失败,sse stream ended without [DONE],也可能是英文客户端的 Stream ended unexpectedly。
这句话的字面意思是:流式响应断了,但没收到约定的结束标记。
OpenAI 兼容的流式响应,正常结尾是固定的两段——先一个带 usage 的块,再一行 data: [DONE]:
data: {"id":"resp_035363...","object":"chat.completion.chunk","choices":[],
       "usage":{"prompt_tokens":9,"completion_tokens":31,"total_tokens":40}}

data: [DONE]
客户端就是靠 [DONE] 判断「说完了」。没等到它,客户端只能认为这轮是失败的——哪怕你已经看到大半截正常的回复。
四种原因,靠断开的规律区分
| 原因 | 典型表现 | 怎么确认 |
|---|---|---|
| 代理或网关超时掐断 | 每次都在固定时长断,比如整 60 秒 | 秒表卡一下,看是不是固定值 |
| 上游中途报错被吞掉 | 短回复正常,长回复才断 | 用小 max_tokens 对比测一次 |
网关自身不发 [DONE] | 任何长度都断,但内容其实完整 | 看是否已经收到 usage 块 |
| 客户端整体超时 | 和网络无关,改客户端配置就好 | 关掉客户端超时再试 |
自己抓一次原始流
绕开客户端,直接看服务端到底发了什么:
curl -sN "$BASE_URL/chat/completions" \
  -H "Authorization: Bearer $KEY" \
  -H "content-type: application/json" \
  -d '{"model":"你的模型ID","messages":[{"role":"user","content":"写 800 字"}],
       "max_tokens":1500,"stream":true}' | tail -5
tail -5 看到什么 | 说明 |
|---|---|
有 usage 块 + data: [DONE] | 服务端没问题,是客户端解析或超时 |
有 usage 块,没有 [DONE] | 网关漏发结束标记,内容其实是完整的 |
| 什么都没有,直接断 | 连接被掐,查代理超时或网关流式支持 |
| 最后一块是一段错误 JSON | 上游报错了,按那段错误的正文继续往下查 |
第二种最容易被误判。 内容明明完整,只因为少一行标记就被客户端判为失败,换个客户端可能就「好了」——问题其实一直在网关。
长连接为什么会被掐、超时该设多少,见Claude Code 国内接入:延迟测量、线路选择与稳定性配置;流式事件本身的完整性判断见流式响应与工具调用兼容性。
Invalid API key / INVALID_API_KEY
字面意思很清楚,但有三个地方容易白查半天。
第一,鉴权头用错了,不是密钥错。 Anthropic 协议要 x-api-key,OpenAI 协议要 Authorization: Bearer。发错头,服务端只会说密钥无效,不会告诉你头用错了。
第二,Base URL 带多了路径。 只写到 /v1,后面的路径由客户端拼。写成完整端点会变成 /v1/chat/completions/chat/completions,落到一个没有鉴权上下文的路由上,报错可能就是密钥无效。
第三,密钥复制时带了不可见字符。 从网页复制常常会带上首尾空格或换行。验一下长度:
printf %s "$KEY" | wc -c        # 和控制台显示的位数对得上吗
printf %s "$KEY" | od -c | tail -2   # 结尾有没有 \n 或空格
一个会误导客户端库的情况
OpenAI 的标准错误结构是这样:
{"error":{"message":"...","type":"invalid_request_error"}}但有的网关在鉴权失败时返回的是另一种形状,比如把 code 和 message 平铺在顶层,没有外层的 error。客户端库按标准结构解析,取不到字段,最后抛给你的可能是一句毫无信息量的「未知错误」,甚至是解析异常。
判断办法是用 curl 直接看原始响应,不要隔着客户端:
curl -s "$BASE_URL/chat/completions" -H "Authorization: Bearer 故意写错" \
  -H "content-type: application/json" \
-d '{"model":"你的模型ID","messages":[]}'选网关时这一项值得单独测——错误路径是你以后花最多时间的地方。判断标准见Claude Code 中转站怎么选:九项可验证的判断标准,密钥本身的存放与轮换见API 密钥安全。
This group does not allow /v1/messages dispatch
返回 403,type 是 permission_error。
这不是密钥无效,也不是端点不存在,是你这个密钥所在的分组没开这个端点。 同一家服务的两个套餐,可能一个能用 Anthropic 的 /v1/messages、另一个只能用 OpenAI 的 /v1/chat/completions。
为什么这条值得单独说:Claude Code 和 Anthropic 官方 SDK 走的就是 /v1/messages。买之前只测了 /v1/chat/completions 能通,接 Claude Code 时才撞上这个 403,是很常见的顺序。
下单前把你实际要用的端点逐个打一遍:
for p in /models /chat/completions /messages /embeddings; do
  printf "%-20s " "$p"
  curl -s -o /dev/null -w "%{http_code}\n" "$BASE_URL$p" \
    -H "Authorization: Bearer $KEY"
done端点覆盖属于下单前必验的四件事之一,其余三件见OpenAI API Key 怎么获取:官方渠道与兼容网关的取舍。
Unsupported value: '...' is not supported with the '...' model
完整报错会把支持的取值列出来,这是它最有用的地方:
Unsupported value: 'minimal' is not supported with the 'gpt-6-astra' model.
Supported values are: 'none', 'low', 'medium', 'high', 'xhigh'.
不要把一个模型的档位列表套用到另一个模型上。 同一家服务下的不同模型,支持的取值可以不一样;同一个模型在不同时间也可能不一样——上游随时会加档位或去掉档位。
我们自己踩过这个坑:给某个模型登记参数时,直接沿用了同系列另一个模型的档位列表,结果其中一档那个模型当时并不支持。后来上游又把那一档加上了,同一份记录先错后对,中间没有任何通知。
所以正确做法不是背下来,是需要时当场问一次——故意传一个肯定不支持的值,让服务端把清单吐出来:
curl -s "$BASE_URL/chat/completions" -H "Authorization: Bearer $KEY" \
  -H "content-type: application/json" \
  -d '{"model":"你的模型ID","reasoning_effort":"definitely-not-a-real-value",
       "messages":[{"role":"user","content":"hi"}],"max_tokens":8}'
报错里的 Supported values are: 就是当下的准确答案。这个技巧对任何枚举型参数都管用。
The image data you provided does not represent a valid image
后面通常跟着支持的格式清单,比如 ['image/jpeg', 'image/png', 'image/gif', 'image/webp']。
两个最常见的原因:
一是格式真的不在清单里。 SVG 是最容易踩的——它在网页里到处都是,但视觉模型基本都不收。清单里没有的格式,先转成 PNG。
二是传了 URL,而上游没拉到那张图。 传 URL 的方式需要上游主动去访问那个地址,失败原因可能是上游的出网限制、地址本身不可达、或者网关没有正确透传。这类失败的报错措辞五花八门,有时是下载失败,有时就是这句「不是有效图片」。
遇到图片相关的报错,先换 base64 试一次。 请求体会变大,但少一个不受你控制的环节:
B64=$(base64 -i ./test.png | tr -d '\n')
curl -s "$BASE_URL/chat/completions" -H "Authorization: Bearer $KEY" \
  -H "content-type: application/json" \
  -d "{\"model\":\"你的模型ID\",\"messages\":[{\"role\":\"user\",
       \"content\":[{\"type\":\"text\",\"text\":\"这是什么\"},
       {\"type\":\"image_url\",\"image_url\":{\"url\":\"data:image/png;base64,$B64\"}}]}],
       \"max_tokens\":64}"
base64 能通、URL 不能通,那问题就在上游拉取那一段,和你的图片本身无关。
图像模型还有一批和文本完全不同的行为——按张计费、尺寸参数可能不被采纳,见GPT Image 2 中转接入:按张计费、参数差异与验收方法。
Service temporarily unavailable
这句话看着像临时故障,但在中转场景下,它常常不是临时的。
典型情况是某个端点压根没开通。比如向一个没接嵌入模型的网关请求 /v1/embeddings,返回的可能就是这句——而不是更准确的「该端点不可用」。你会以为等一会儿就好,实际等多久都一样。
区分真临时故障和没开通,看两件事:
| 观察 | 真·临时故障 | 端点没开通 |
|---|---|---|
| 换个端点试 | 也一起失败 | 其他端点正常 |
| 隔十分钟重试 | 可能恢复 | 一模一样 |
| 服务商状态页 | 通常有记录 | 没有记录 |
/v1/embeddings 是最容易缺的一个。要做知识库或检索的话,这一项必须在下单前确认,事后加不了。
怎么抓到一手报错,而不是客户端转述的
上面每一条都强调用 curl 直接看。原因是客户端会对错误做二次包装:有的把原文吞掉只留一句「请求失败」,有的把 401 转成 500,有的干脆只打印异常栈。
一个通用的抓取模板,把状态码、耗时和完整响应体一次拿全:
BASE_URL="https://你的网关/v1"; KEY="你的密钥"

curl -s -w "\n--- HTTP %{http_code}  耗时 %{time_total}s ---\n" \
  "$BASE_URL/chat/completions" \
  -H "Authorization: Bearer $KEY" \
  -H "content-type: application/json" \
-d '{"model":"你的模型ID","messages":[{"role":"user","content":"hi"}],"max_tokens":16}'贴报错给别人看之前,先把密钥抹掉。响应体里一般不会带密钥,但你的命令行会。
把这些变成长期可查的记录,而不是每次临时抓,做法见中转站可观测性。
常见问题
报错里没有英文原文,只有一句中文「请求失败」,怎么办?
那是客户端包装过的。用本文最后一节的 curl 模板直接打一次同样的请求,服务端的原始响应体里才有可查的信息。客户端转述的错误基本无法定位。
同一条报错,换个客户端就好了,说明什么?
多半说明服务端行为是有问题的,只是两个客户端的容错程度不同。最典型的是网关漏发 data: [DONE],严格的客户端判为失败,宽松的客户端照常结束。这种情况服务端才是根因。
报错里提到的模型名和我填的不一样,是怎么回事?
转发层通常原样透传上游的错误文本,所以报错里可能出现上游实际使用的模型名。这反过来是个有用的验证手段——能用来核对网关声称的模型和实际调用的是不是同一个。
为什么建议故意传一个错误的参数值?
因为服务端在拒绝时会把支持的取值列出来,这是获取当下准确清单最省事的办法。文档可能过期,报错不会。
这些报错是通用的吗,还是只在某一家出现?
本文列的都是 OpenAI 兼容协议下的通用报错,措辞由上游决定,所以在不同网关上大同小异。但具体哪些端点开通、错误结构是否标准,各家不同,需要自己测。
继续阅读
API 中转站错误码:400、401、404、422、429 与 5xx 排查
手上只有状态码没有报错正文时,按码分层定位,并生成可交付的脱敏诊断包。
Claude Code 国内接入:延迟测量、线路选择与稳定性配置
长连接为什么被掐断、超时与重试该怎么设,用可复制的命令逐段定位。