Claude Code 国内接入:延迟测量、线路选择与稳定性配置
能连上和好用之间还有很长一段距离。首字节两秒和八秒的差别,在编码工作流里是能不能用的区别。这一段的优化不靠玄学,靠测量:先有基线,再动配置。
先建立基线,再谈优化
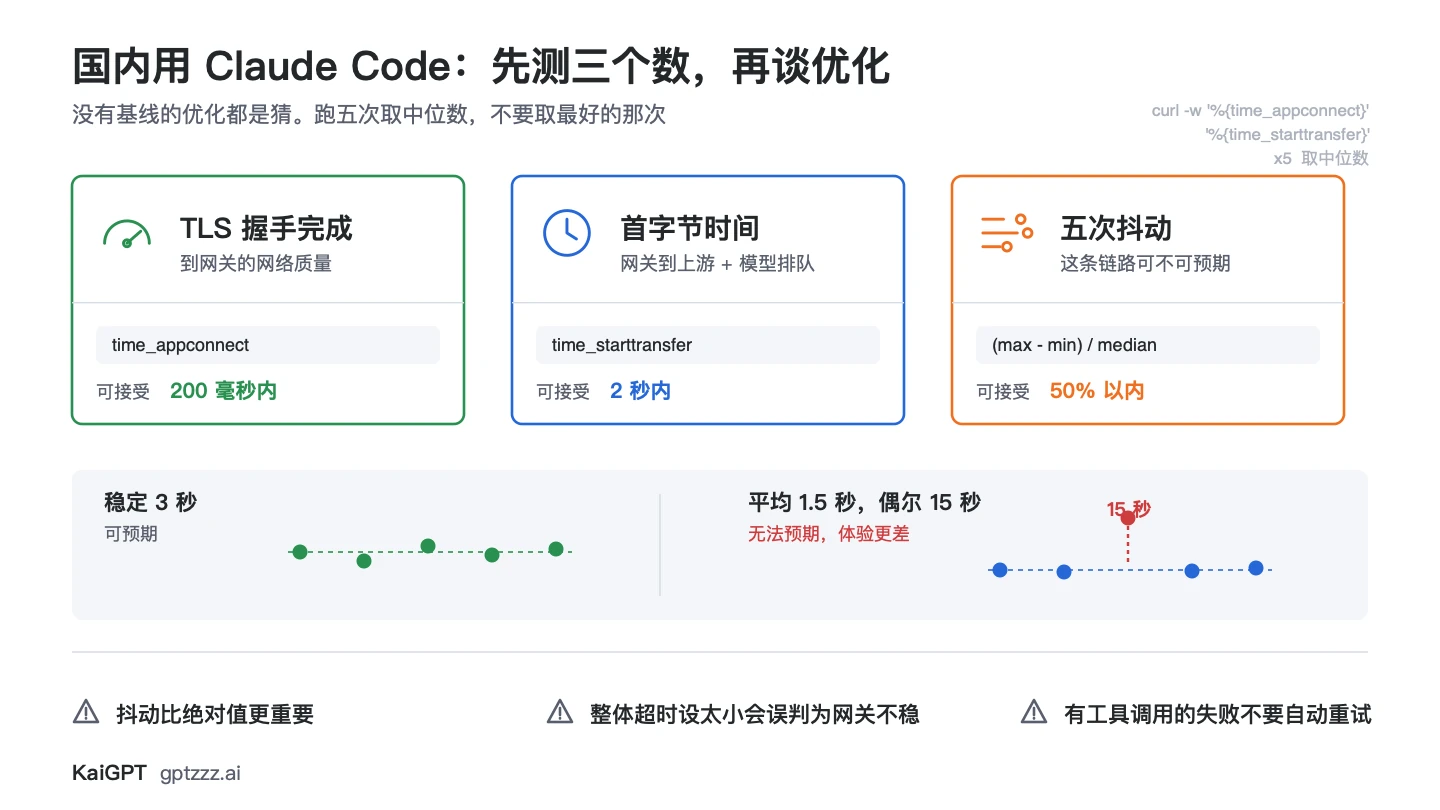
没有基线的优化都是猜。换网关、换 DNS、改超时——做完这些之后,你凭什么说变好了?先测三个数,记下来。
for i in 1 2 3 4 5; do
  curl -s -o /dev/null \
    -w "%{time_namelookup} %{time_connect} %{time_appconnect} %{time_starttransfer} %{time_total}\n" \
    -X POST "$ANTHROPIC_BASE_URL/messages" \
    -H "Authorization: Bearer $ANTHROPIC_AUTH_TOKEN" \
    -H "anthropic-version: 2023-06-01" \
    -H "content-type: application/json" \
    -d '{"model":"你的模型ID","max_tokens":16,"messages":[{"role":"user","content":"hi"}]}'
done跑五次取中位数,不要取最好的那次。最好的那次通常是连接复用后的结果,代表不了你平时的体感。
| 指标 | 含义 | 可接受范围(经验值) |
|---|---|---|
TLS 握手完成(time_appconnect) | 到网关的网络质量 | 200 毫秒内 |
首字节时间(time_starttransfer) | 网关到上游 + 模型排队 | 2 秒内 |
| 五次抖动 | 这条链路可不可预期 | 中位数的 50% 以内 |
抖动比绝对值更重要。 平均 1.5 秒但偶尔 15 秒的链路,体验比稳定 3 秒差得多。稳定 3 秒你会习惯,偶尔 15 秒你每次都得盯着看它是不是卡死了。
把这三个数记在一个文件里,每次改配置后重跑一遍对比。系统化地做这件事的方法,见中转站稳定性基准测试。
瓶颈在哪一段,解法完全不同
拿到基线以后,看是哪一段拖的。这一步决定了你该动什么——动错地方不会有任何改善。
| 慢的位置 | 说明 | 能做什么 |
|---|---|---|
| DNS 解析超过 100 毫秒 | 本地 DNS 慢或被干扰 | 换 DNS,或在 hosts 里固定 |
| TLS 握手超过 500 毫秒 | 到网关的链路差 | 换网关节点,或走代理 |
| 首字节超过 5 秒 | 网关到上游慢,或模型排队 | 换网关,或换模型 |
| 首字节正常但总时长很长 | 模型输出慢,属正常 | 换更快的模型,或降低 max_tokens |
最后一行值得展开。推理型模型的首字节可能很快,但总时长长,因为它在思考。 这不是网络问题,换多少个网关都没用。
如果你的任务不需要深度推理——改个变量名、写个 CRUD——用推理档位低的模型或调低 reasoning 参数,总时长能显著下降。不同模型支持的推理档位不一样,同一套参数不能直接套用到另一个模型上,配置前先确认。
四类症状的分层排查方法在Claude Code 镜像与加速接入里有更完整的命令;如果你还在选网关,先看Claude Code 中转站怎么选。
超时设成多少
默认超时对编码场景往往太短。Claude Code 的一次工具调用往返可能涉及长上下文,几十秒是正常的。
| 参数 | 建议 | 理由 |
|---|---|---|
| 连接超时 | 10 秒 | 连不上就该快速失败,不要干等 |
| 首字节超时 | 60 秒 | 给模型排队留余量 |
| 整体超时 | 不设,或设很大 | 长输出任务可能跑几分钟 |
整体超时设得太小是最常见的配置错误。 表现是长任务跑到一半突然断,看起来像网关不稳,实际是客户端主动掐的。这个误判会让你去换网关,换完一样断。
区分方法很简单:看断开的时间点是不是固定的。每次都在 60 秒整断,那是超时;时间点随机,才可能是链路问题。
如果你在代理软件里配了统一超时,检查那个值。很多代理默认 60 秒,对流式长输出是不够的——而且它掐的是 TCP 连接,客户端只会看到一个没头没尾的中断。
重试要小心
重试能提高成功率,但对 LLM 调用有个特殊风险:工具调用的重试可能导致副作用执行两次。
比如一个写文件的工具调用,第一次实际执行成功了但响应超时,重试会再写一次。发 HTTP 请求、建资源、发消息这类工具,重复执行的后果更严重。
| 情况 | 能不能重试 |
|---|---|
| 连接失败,请求没发出去 | 能,安全 |
| 429 限流 | 能,按 retry-after 退避 |
| 5xx 且是纯文本生成 | 能 |
| 5xx 但本轮有工具调用 | 不要自动重试,交给人判断 |
| 流式中断到一半 | 不要重发整个请求,成本翻倍且可能重复执行 |
最后一条容易被忽略:流式已经产出的部分是计过费的,重发整个请求等于为同一段输出付两次钱。
重试与故障回退的完整策略,包括退避曲线和熔断,见中转站重试与故障回退。
并发的取舍
并发能提高吞吐,但在网关场景下有两个约束。
第一,网关本身有速率限制。 超了会返回 429,重试又加重拥塞,形成正反馈——越急越慢。
第二,同一个账号的并发请求可能被上游排在同一个队列里。 并发数上去了但每个都变慢,总时间没省多少,而失败率上升了。
建议做法:先用串行跑通,测出单次耗时;再逐步提高并发看总吞吐是否线性增长。不再线性增长的那个点,就是你的并发上限,超过它只会增加失败率。
要长期盯住这些数,需要把延迟、错误率、429 比例记下来,做法见中转站可观测性。
把配置写进 settings 而不是 shell
只在 shell 里 export 的变量有两个问题:开新终端就没了;后台进程和某些编辑器集成拿不到。
Claude Code 支持配置文件。把端点和鉴权写进去之后,用 /status 确认它实际在用的值:
/status这一步能排掉「明明配了但没生效」这类问题。配置文件的优先级高于环境变量,所以如果你两处都配了且值不同,实际生效的可能不是你以为的那个。
另一个可靠的确认方式是看网关侧的用量记录——有对应时间的调用,就说明请求确实走的是它。
一张自查表
| 检查项 | 通过标准 |
|---|---|
| TLS 握手中位数 | 200 毫秒内 |
| 首字节中位数 | 2 秒内 |
| 五次抖动 | 中位数的 50% 以内 |
| 长流式不中断 | 以 message_stop 正常结束 |
| 整体超时 | 未设或足够大 |
| 工具调用不自动重试 | 已确认 |
| 配置写进 settings | /status 显示正确 |
七项全过,国内使用 Claude Code 的体验就接近可用了。
有任一项不过,先解决它再考虑换网关。 后四项全是你这边的配置,和网关没关系——带着一个 60 秒超时的代理去换网关,换几家都一样。
常见问题
换个网关能把延迟降下来吗?
要看瓶颈在哪。如果是 TLS 握手慢,换节点有效;如果是首字节慢,取决于新网关到上游的链路,换了也可能一样;如果是模型本身输出慢,换网关完全没用。先按第二节定位再决定。
晚上比白天慢很多,正常吗?
上游在高峰期排队会让首字节变长,这是普遍现象。但如果 TLS 握手也同步变慢,说明是网关侧或你本地的网络拥塞,不是上游排队。这两者的处理方式完全不同,靠拆分阶段才能区分。
要不要自己部署一个中转?
自建能掌控线路和故障行为,代价是要自己维护上游账号、限流、重试和监控。调用量不大时,维护成本通常高于直接用现成服务。
为什么长任务总在同一个时间点断?
断点固定几乎一定是超时设置,不是网络。依次检查客户端的整体超时、代理软件的超时、以及网关的流式超时。随机时间点的中断才需要怀疑链路。
继续阅读
Claude Code 镜像与加速接入:先分清三类问题再动手
按安装源、API 端点、上游链路、长连接四层分别定位,给出可复制的诊断命令。
中转站稳定性基准测试
用可重复的方法长期记录延迟、错误率与中断,把体感变成可比较的数。