API 重试机制:退避、熔断与兼容回退设计
API 重试机制如何避免风暴?先过幂等门禁,再限制重试预算,使用指数退避与抖动、熔断和能力兼容的 fallback。
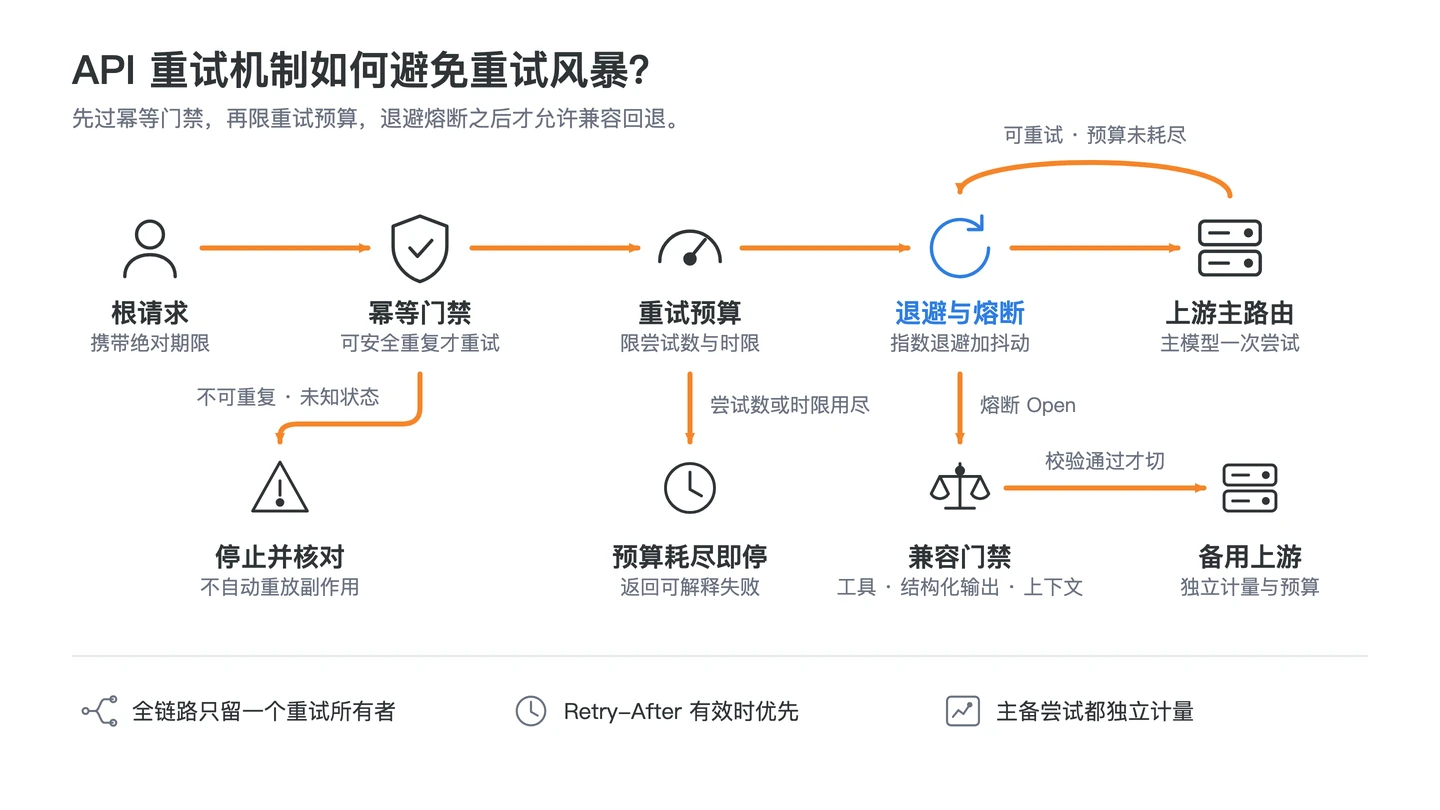
设置 API 重试时,只有暂时失败、可安全重复且仍在一个全局截止时间与重试预算内的请求才重试;持续失败要熔断,回退前要验证能力。
第一道门:幂等性早于状态码
| 状态 | 例子 | 重试门禁 |
|---|---|---|
| 可安全重复 | 无外部写入的生成请求 | 仍需检查流是否开始与剩余预算 |
| 业务幂等 | 写入端按业务幂等键去重 | 确认键跨网关与工具执行端传递 |
| 未知/不可重复 | 发送消息、支付、创建工单 | 默认不自动重放,先核对状态 |
request_id 用于关联,不能替代写入端实际执行去重的业务幂等键。流式请求一旦产生可见输出或工具调用,重放还可能造成重复文本、重复副作用与额外费用。
预算化 full jitter 可执行示例
import random
import time

def next_wait_ms(retry_index, remaining_ms, retry_after_ms=None,
                 base_ms=250, cap_ms=4000, min_attempt_ms=300):
    if remaining_ms <= min_attempt_ms:
        return None
    local_cap = min(cap_ms, base_ms * (2 ** retry_index))
    local_wait = random.randint(0, local_cap)
    candidate = retry_after_ms if retry_after_ms is not None else local_wait
    wait_ms = min(max(candidate, 0), remaining_ms - min_attempt_ms)
    return wait_ms if wait_ms > 0 else None

for retry_index in range(3):
    wait_ms = next_wait_ms(retry_index, remaining_ms=5000)
    if wait_ms is None:
        break
    print({"retry_index": retry_index, "wait_ms": wait_ms})
    time.sleep(wait_ms / 1000)
顺序是:先判错误、幂等与流状态,再判最大尝试数和剩余 deadline;有效且受上限约束的 Retry-After 优先,否则使用 full jitter。整个调用链只能有一个重试所有者,避免 SDK、网关和业务层相乘。
熔断、背压与回退门禁
- 背压:有界队列、过期丢弃、并发削减;429 后先降低发送速率。
- 熔断:按 provider/model/region/route 建独立滚动窗口和最小样本;Closed → Open → Half-open → Closed,每次转换写 telemetry。
- 半开:只允许有限探针;失败立即重新打开,连续成功条件由业务配置。
- 回退:检查 API 形状、工具、结构化输出、上下文、数据边界、成本上限和回归 eval。
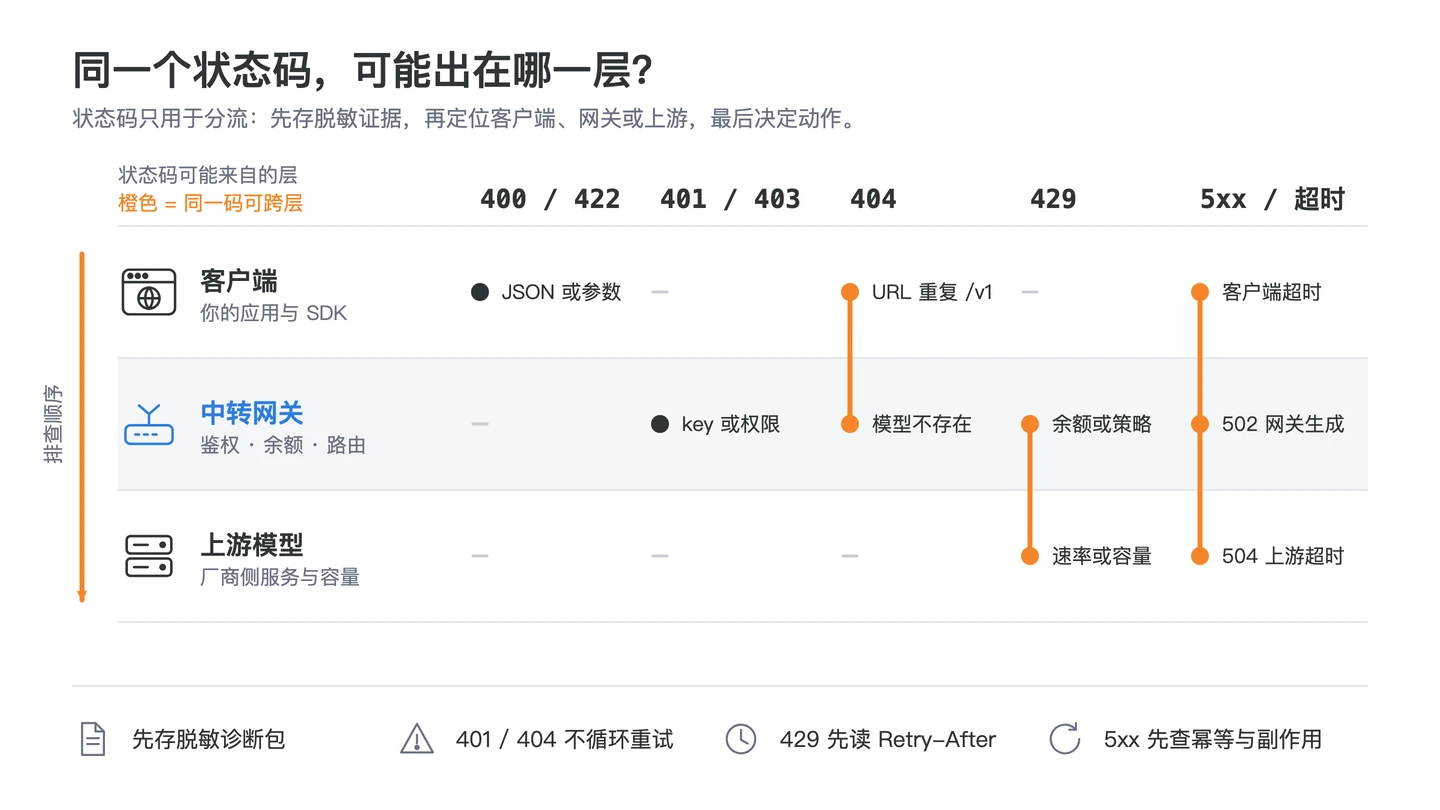
状态码分类与 Retry-After 解析见错误码排查;每次 primary/fallback 尝试都应独立计量。
故障演练与校验清单
| 注入场景 | 预期动作 | 必须核对 |
|---|---|---|
| 429 rate limit | 降并发、受限等待 | 尝试数、deadline、Retry-After |
| 503 | 幂等且有预算才重试/回退 | 成本与 attempt span |
| 网络超时 | 先核对未知执行状态 | 重复副作用 |
| 400/401 | 立即停止 | 无重试噪声 |
| 部分流 | 标记不完整,交给业务决策 | 无静默重放 |
- 最大尝试数和总截止时间同时生效。
- 所有停止原因可在日志和 trace 中解释。
- 熔断状态、探针、fallback route 和费用可关联。
- 副作用工具使用真正的业务幂等键或禁止自动重放。
故障定位路径:根请求 → 尝试 → 熔断 → 回退
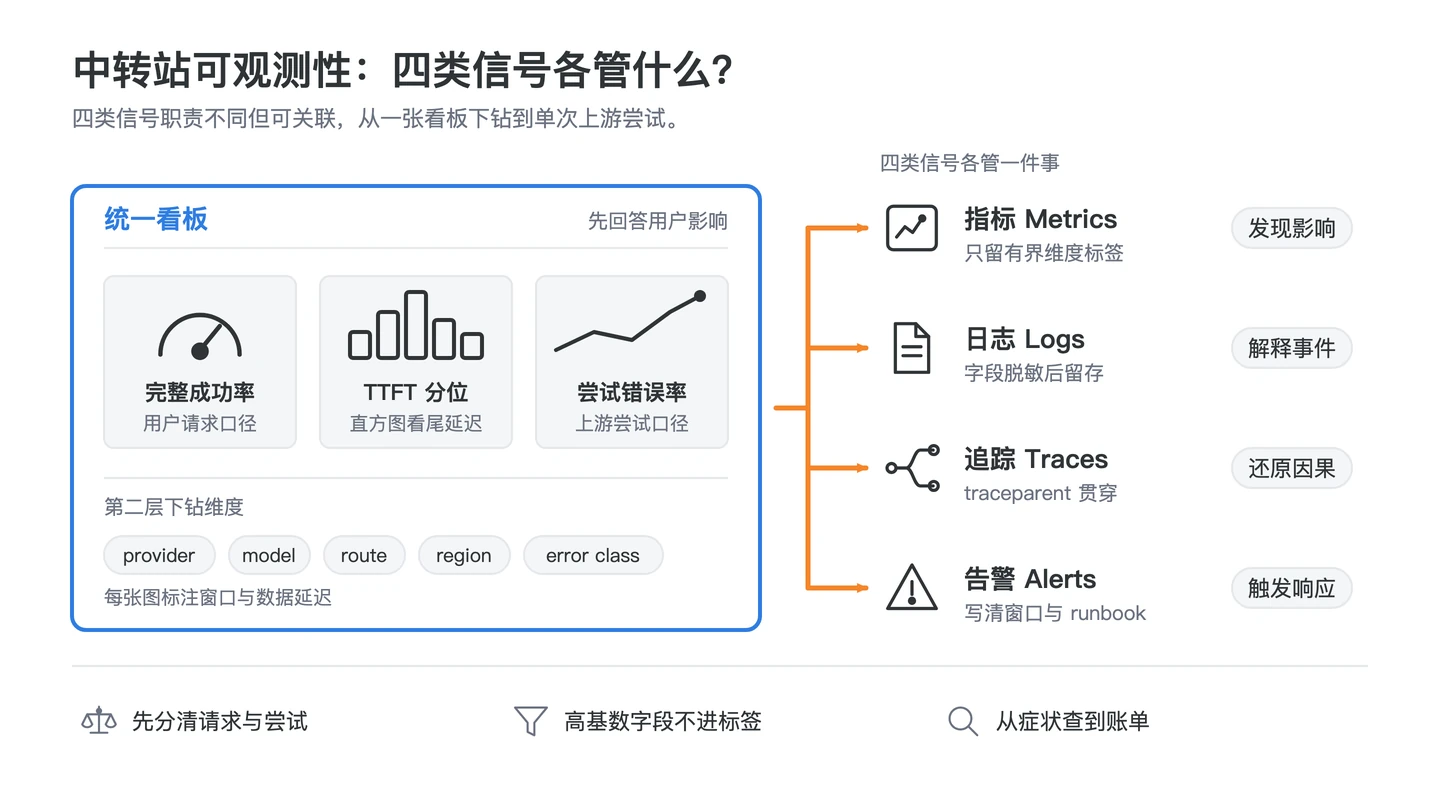
先用 root trace 找到 user_request,再枚举每个 upstream_attempt 的状态、等待和流进度;若大量根请求在同一路由累积,检查队列与熔断;若回退成功但成本或格式异常,检查兼容门禁和独立用量记录。实现字段参考API 中转站可观测性。
运行低强度对照时用稳定性基线分开统计根请求成功率与上游尝试错误率。Anthropic 文档说明其 SDK 对部分瞬态错误采用指数退避并遵循服务端 Retry-After,但不要把任一 SDK 的默认次数或状态集合硬编码成全行业规则。
常见错误与误读
- SDK、网关、队列消费者各自重试,形成指数级重试风暴。
- 只看 429 或 5xx,不先检查幂等、副作用和流状态。
- 固定等待无抖动,所有客户端同时再次冲击上游。
- 熔断器使用全局键,让一个模型故障拖累所有路由。
- 把 fallback 当成无损替代,忽略工具、schema、隐私和成本差异。
本文不提供通用重试次数、毫秒阈值或熔断比例;这些都是随业务 deadline、样本、模型和副作用而配置的参数。流式协议细节可另查流式与工具调用兼容性。
重试所有权、状态机与验收配置
先画调用图并给唯一一层“重试所有者”标签。客户端 SDK 若负责重试,网关只做一次上游尝试或明确接收剩余预算;网关若负责,SDK 与队列消费者必须关闭自动重试。调用者传递绝对 deadline、幂等上下文和已用尝试数,不能让下游重新获得完整预算。日志同时记录 root request 的预算与每次 attempt 的消耗。
错误分类函数的输入不只含 status,还含机器错误类型、网络阶段、Retry-After 有效性、stream_state、tool_state、幂等状态与剩余时间。输出应是 stop、retry、fallback 或 reconcile,并带原因码。400/401/403/404/422 默认 stop;429 与 5xx 是候选而非许可;未知执行状态或部分流默认 reconcile。
等待算法需要处理边界:Retry-After 可以是秒数或 HTTP 日期,无法解析、为负或超过本地上限时按策略拒绝或截断;full jitter 的指数要限制,避免溢出;系统休眠后重新计算剩余 deadline。等待本身也创建 span/event,记录计划值、实际值、来源、取消原因,才能区分“上游慢”和“客户端在退避”。
熔断器的配置至少包括 scope key、滚动窗口、最小样本、计入的错误类别、打开条件、open 时长、half-open 并发与重新关闭条件。所有数值是部署配置而非行业默认。Open 状态返回可解释的失败或进入显式兼容回退,不得伪装成成功。Half-open 探针使用无副作用、受预算请求,并避免所有实例在同一时刻探测。
回退允许列表按任务类型维护,而不是只按模型名。记录请求/响应 API 形状、工具调用、结构化输出 schema、上下文上限、数据驻留与隐私、费用上限、质量 eval 和版本日期。primary 与 fallback 各有独立 attempt ID、model/route、usage 和错误;根请求只汇总最终用户结果,不覆盖中间成本。
流式恢复再分三个状态:连接前失败可按普通门禁;连接后但首个有意义事件前可在安全时有限重试;产生可见内容或工具后禁止静默重放。业务可以提供“继续生成”“重新开始”“核对工具状态”等显式动作,但必须把原结果标记为不完整并告知额外费用可能性。
验收时对每个故障注入验证尝试上限、总时长、等待分布、重复副作用、熔断转换、fallback 能力、日志/trace、告警和费用。测试还要覆盖取消信号、进程重启、队列过期和时钟变化。只有根请求与每个 attempt 都能回放状态转换,韧性实现才算可审计,而不是“看起来最后成功”。
请求、响应与参数边界验收表
重试控制器的请求边界是根请求 ID、绝对 deadline、业务幂等键、stream/tool 状态和已用 attempt 数;响应边界是状态、机器错误类型、有效 Retry-After、是否出现可见输出、usage 与执行状态。参数边界包括最大尝试、单次超时、base/cap、最小有效调用窗口、费用预算、熔断 scope 和回退允许列表,所有数值来自部署配置而非文章默认。
| 阶段 | 请求/参数输入 | 响应/状态输出 | 失败模式 | 验证指标与回滚 |
|---|---|---|---|---|
| 重试门禁 | error、idempotency、stream_state、deadline | stop/retry/reconcile 与原因码 | 超时后执行状态未知、部分流、重复工具 | 重复副作用必须为零;未知状态进入核对 |
| 等待与 API 熔断 | Retry-After、full jitter、滚动窗口、最小样本 | 实际等待、Closed/Open/Half-open 转换 | 多层重试、同步尖峰、全局熔断误伤 | attempt 数、deadline、转换原因可追踪;异常时关闭重试开关 |
| API fallback | 能力、schema、数据边界、费用和 eval 版本 | 独立 route、model、usage 与最终结果 | 格式不兼容、额外扣费、隐私边界变化 | 回退率与额外 attempt 费用分列;不兼容即回滚允许列表 |
“API 熔断和降级有什么区别”可从动作判断:熔断阻止继续冲击已失败路由,降级或 API 故障切换选择经过验证的可解释结果;两者都不能伪装成原模型成功。“API fallback 如何校验模型能力”则要跑工具、结构化输出、上下文与业务 eval。故障演练后若任一层偷偷恢复默认重试,先关闭所有自动重试与回退,恢复上一版预算和 scope,再用一个无副作用 Half-open 探针验证。
一手资料
停止、回滚与恢复步骤
当全局 deadline、最大尝试、费用预算耗尽,出现部分流/未知副作用,或熔断器进入 Open 时停止新重试。紧急回滚先通过配置开关关闭重试与 fallback,保留直接失败的可解释响应;再回滚到上一版策略、scope key 和兼容允许列表。恢复时从单一路由、单个无副作用探针开始,进入 Half-open 的并发必须受限;确认等待、attempt、幂等、用量和告警正确后再逐步关闭熔断。任何未知工具状态先 reconcile,不能靠重放“恢复”。
执行问题与参数边界
以下回答用于定位常见执行问题。实际判断仍需结合本文的参数、失败模式和验证指标,不应仅凭一项现象推断服务能力。
API 重试机制怎么设计
API 重试策略从幂等、流状态、错误类型与重试预算开始。
API 429 应该重试几次
最大尝试与总 deadline 双重限制,不设通用次数。
API 指数退避和抖动怎么设置
指数退避采用受 cap 约束的 full jitter,并记录等待来源。
API 超时后能不能重试
先判断上游执行是否未知和幂等键是否真正生效。
流式 API 中断后如何处理
首事件后停止静默重放,转业务恢复。
API 故障切换如何避免重复扣费
API 故障切换为每次 API fallback 单独记录 attempt 与用量。
常见问题
API 重试机制怎么设计?
先判断错误是否暂时和请求是否可安全重复,再由唯一重试所有者在最大尝试数与总截止时间内执行受限退避;持续故障熔断,兼容验证后才回退。
API 429 应该重试几次?
没有通用次数。先区分速率、配额和余额,遵循有效且有上限的 Retry-After,并让最大尝试数与剩余 deadline 任一耗尽就停止。
request ID 能替代幂等键吗?
不能。request ID 用于日志和追踪关联;业务幂等键必须由实际产生副作用的写入端识别并去重。
流式 API 中断后能自动重试吗?
首个有意义事件之前且请求可安全重复时可以受限重试;开始输出或工具执行后应标记不完整并由业务选择继续、重启或人工核对。