API 中转站可观测性:指标、日志、追踪与告警
API 中转站可观测性如何落地?定义请求边界,关联指标、日志和分布式追踪,定位上游尝试并完成用量、SLO 与告警复盘。
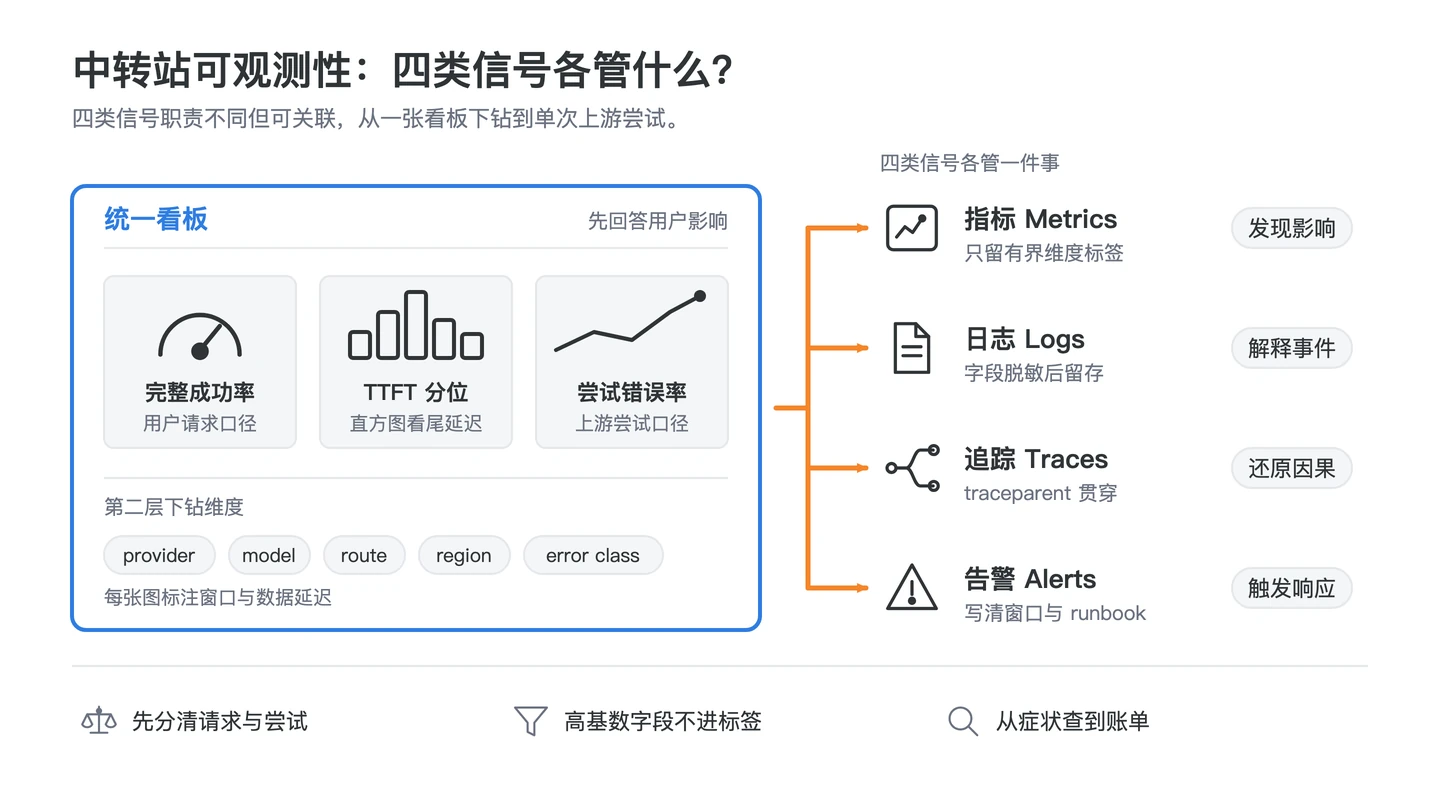
建立 API 中转站可观测性时,先区分一次用户请求和多次上游尝试,再用低基数指标发现影响、结构化日志解释事件、分布式追踪还原因果,最后把用量与账单连接起来。
先区分 user_request 与 upstream_attempt
一个 user_request 可能因为重试或 fallback 包含 N 个 upstream_attempt。用户请求成功率回答“用户最终是否得到完整结果”,尝试错误率回答“上游付出了多少失败、容量和费用”。把两者混在一起,会让最终 200 隐藏上游故障。
| 信号 | 职责 | 关联键 |
|---|---|---|
| Metrics | 发现聚合影响、趋势和饱和 | 有限的 provider/model/route/region/error_class |
| Logs | 解释单个事件和字段变化 | trace_id、user_request_id、attempt_id |
| Traces | 还原鉴权、排队、路由、重试和结算因果 | trace/span context |
OpenTelemetry 将 traces、metrics、logs 定义为可关联但职责不同的 signals;W3C Trace Context 定义 traceparent/tracestate 传播格式。
用自有 traceparent 发出可关联探针
export RELAY_BASE_URL="https://relay.example/v1"
export TEST_KEY="replace-with-lab-key"
export MODEL_ID="replace-with-model-id"
export TRACEPARENT="00-4bf92f3577b34da6a3ce929d0e0e4736-00f067aa0ba902b7-01"
curl -sS -D response-headers.txt -o response.json   "$RELAY_BASE_URL/chat/completions"   -H "Authorization: Bearer $TEST_KEY"   -H "traceparent: $TRACEPARENT"   -H "X-Client-Request-Id: lab-observe-001"   -H "Content-Type: application/json"   --data "{\"model\":\"$MODEL_ID\",\"messages\":[{\"role\":\"user\",\"content\":\"Reply: ok\"}],\"max_tokens\":8}"
该命令只演示本地关联。中转可能不透传厂商请求头或 W3C 上下文,必须记录实际行为;不要把 API key、prompt、用户内容或个人数据放进 tracestate 或 baggage。
字段、指标与基数策略
- 关联:
trace_id、user_request_id、attempt_id、厂商 request ID。 - 路由:provider、model、route、region;不记录密钥明文。
- 计时:
queue_ms、connect_ms、TTFT、stream_gap、total_ms。 - 结果:status、error_class、finish、
retry_count、breaker_state、fallback。 - 用量:input/output/billable、来源与结算状态。
Metrics 标签只保留有界维度。request_id、trace_id、用户 ID、密钥指纹、原始 URL、prompt 和输出属于高基数或敏感字段,只能进入受控日志/追踪,不能成为 Prometheus label。
仪表盘、SLO 与告警校验清单
- 顶层同时展示 user_request 成功/延迟与 upstream_attempt 错误/成本。
- 可以按 provider、model、route、region、error class 下钻。
- TTFT、总延迟和 stream gap 使用直方图,不只展示平均值。
- 告警包含影响、窗口、基线、负责人、runbook、仪表盘/trace 链接与静默规则。
- 持续用户可见错误才 page;供应商退化或对账积压可 ticket;孤立预期失败仅留仪表盘。
- 每日将每次 attempt 用量汇总到 user_request 并与账单对账。
SLO 和阈值必须从业务影响与历史基线制定,没有适用于所有模型、时段和路由的固定数字。
故障定位路径:症状 → trace → attempt → 账单
从用户成功率、TTFT 或流中断告警选取受影响维度,进入 root trace;查看 auth、quota、queue、route 与每个 attempt span;再用 attempt ID 查脱敏日志和错误体,最后核对重试/fallback 用量。若只有 attempt 错误上升而 user_request 成功不变,仍要检查容量和成本。
错误类型参考API 中转站错误码,attempt 预算和熔断状态参考API 重试机制,基线指标口径参考稳定性测试。
常见错误与误读
- 只监控最终 HTTP 200,遗漏部分流失败与隐藏重试。
- 把 request_id/trace_id 放入指标标签,造成高基数爆炸。
- 默认记录完整 prompt、输出、Authorization 或 Cookie。
- 只看平均延迟,忽略 TTFT、尾延迟和 stream gap。
- 告警没有窗口、影响、负责人和可执行 runbook。
用量差异需要结合倍率与账单复算。本文限制:字段名是可移植设计,不承诺兼容中转会保留 OpenAI x-request-id 或 Anthropic request-id,也不提供通用 SLO。
事件契约、看板与对账闭环
定义版本化事件契约,至少包含 schema_version、时间、signal/event 名、trace/span、user_request、attempt、route、timing、result、usage 和 privacy_class。新增字段保持向后兼容;删除或改变语义时升主版本。采集端验证类型和允许枚举,非法记录进入隔离队列而不是静默丢弃。所有时间统一单位并保存时区,持续时间来自单调时钟。
根请求事件记录客户端看到的最终状态、完整/部分流、总耗时和汇总用量;attempt 事件记录 provider/model/route、连接、TTFT、状态、错误类、重试原因和单次用量。backoff、breaker transition、fallback selection 与 billing settlement 都是独立事件,通过 trace 与 attempt 关联。这样即使最终成功,也能看到隐藏的失败和额外费用。
首层看板只回答用户影响:请求量、完整成功率、部分流、TTFT/总延迟分位和受影响任务。第二层按 provider/model/route/region/error class 下钻上游尝试、429、5xx、队列、连接、重试与熔断;第三层进入 exemplar/trace 和脱敏日志。每张图都显示窗口、样本、单位和数据延迟,避免把结算延迟误读为实时用量下降。
告警规则绑定 runbook 与 owner。页面级告警要求持续、用户可见且有立即动作;容量趋势、单一供应商退化、账单差异积压可创建工单;孤立的预期 4xx 只用于分析。告警消息包含开始时间、当前窗口、基线、影响维度、最近变更、看板与 trace 链接、静默和升级条件。恢复通知同样写明是否真正恢复或仅流量下降。
对账作业以 attempt usage 为输入,分别保存供应商响应、网关估算和最终结算三种来源;重试和 fallback 不合并丢失。再按 user_request 汇总呈现用户视角。差异队列记录金额/Token 类别、模型、时间窗、数据来源和处理状态,但不在指标标签中加入 request ID。超过保留期后按策略删除细粒度内容,保留必要聚合与审计记录。
每次受控故障演练都要求同一个根请求能从告警定位到看板维度、trace、attempt 日志、熔断/回退事件和账单项。任一环断开就记录为观测缺口。演练结束检查高基数、日志脱敏、访问控制、采样是否遗漏失败、保留期和告警噪声;修复后用相同场景复测,而不是只确认仪表盘“有数据”。
请求、响应与参数边界验收表
一次观测探针的请求边界包括自有 user_request_id、traceparent、模型、route、流式模式、超时和敏感数据分类;响应边界包括每个 upstream_attempt 的状态、错误类型、TTFT、完成状态、usage、供应商请求 ID 与账单状态。参数边界固定采样率、直方图区间、保留期、允许标签、SLO 窗口和告警路由;这些配置必须版本化,不能把测试阈值写成厂商保证。
| 信号 | 请求/参数边界 | 响应证据 | 失败模式 | 验证指标与回滚 |
|---|---|---|---|---|
| Metrics | provider/model/route/region/error_class 等有限维度 | 请求量、成功、429、TTFT、总耗时、饱和度 | request_id/trace_id 进入 label 导致基数爆炸 | series 数与缺失率受控;异常时回滚新增标签 |
| Logs / Traces | traceparent、脱敏策略、采样与保留期 | root span、attempt span、事件、错误和路由 | 上下文断裂、密钥/提示词泄漏、时钟错位 | 关联成功率与 span 完整率;泄漏时停采并清理派生索引 |
| Billing / Alerts | SLO 窗口、用户影响、负责人和费用口径 | 每次 attempt 用量、根请求汇总、告警状态 | 只看最终 200、重试费用漏算、短尖峰噪声 | 对账差异率与可操作告警率;规则异常回滚版本 |
“API 链路追踪 traceparent 怎么传递”应按 W3C 格式跨服务传播,但不得在 tracestate 或 baggage 放密钥、prompt 或用户内容;“API 用量和账单如何对账”要先汇总 attempt,再映射到 user_request;“API SLO 和告警阈值怎么设置”则从用户可见影响、基线和响应动作反推。AI 可观测性并不等于全量记录内容,默认应最小化、脱敏并可回滚。
一手资料
停止、回滚与恢复步骤
采集到密钥/完整内容、指标基数异常、遥测队列反压主请求或 schema 错误激增时停止新增采集,优先保护业务路径。通过采样/采集开关回滚到上一版事件契约和标签白名单,隔离不合规事件并按保留策略删除敏感副本。恢复时先在单一路由验证脱敏、标签基数、trace 连通和数据延迟,再逐步扩大;重放遥测只写离线修复流,不能重复业务请求或账单。告警恢复前还要确认看板、trace、日志与对账对同一根请求一致。
执行问题与参数边界
以下回答用于定位常见执行问题。实际判断仍需结合本文的参数、失败模式和验证指标,不应仅凭一项现象推断服务能力。
API 中转站可观测性怎么做
API 可观测性用 metrics、API 日志与分布式追踪关联请求。
API 请求 ID 如何追踪
API 链路追踪保存请求 ID、trace 与 attempt 的映射。
AI API 需要监控哪些指标
API 监控同时看用户结果、上游尝试、延迟、饱和与用量。
API TTFT 和总延迟怎么监控
分别建直方图并按有界维度下钻。
API 流式中断如何告警
只有持续且用户可见、值班者可行动时触发 API 告警。
API 网关日志字段设计
关联、路由、计时、结果、用量和隐私字段要版本化。
常见问题
API 中转站可观测性怎么做?
先区分 user_request 与 upstream_attempt,使用低基数指标发现影响、脱敏日志解释事件、trace 还原链路,并以 trace/request/attempt ID 连接用量与账单。
AI API 需要监控哪些指标?
至少监控用户请求量和成功率、上游尝试错误、429、TTFT、总耗时、流中断、队列与连接饱和、重试、熔断、fallback 以及用量成本。
哪些字段不能作为 metrics 标签?
request_id、trace_id、用户 ID、密钥指纹、完整 URL、prompt 和输出等高基数或敏感字段应进入受控日志或追踪,而不是指标标签。
API 告警怎样避免噪声?
只对持续且用户可见、值班者有明确动作的影响告警,并附影响范围、窗口、基线、负责人、runbook、下钻链接和静默升级规则。