API 流式输出与工具调用兼容性:SSE 状态机测试
API 流式输出与工具调用兼容性取决于 SSE 分帧、调用聚合、工具结果和完成或错误四段状态;最终文字相同,不代表协议兼容。
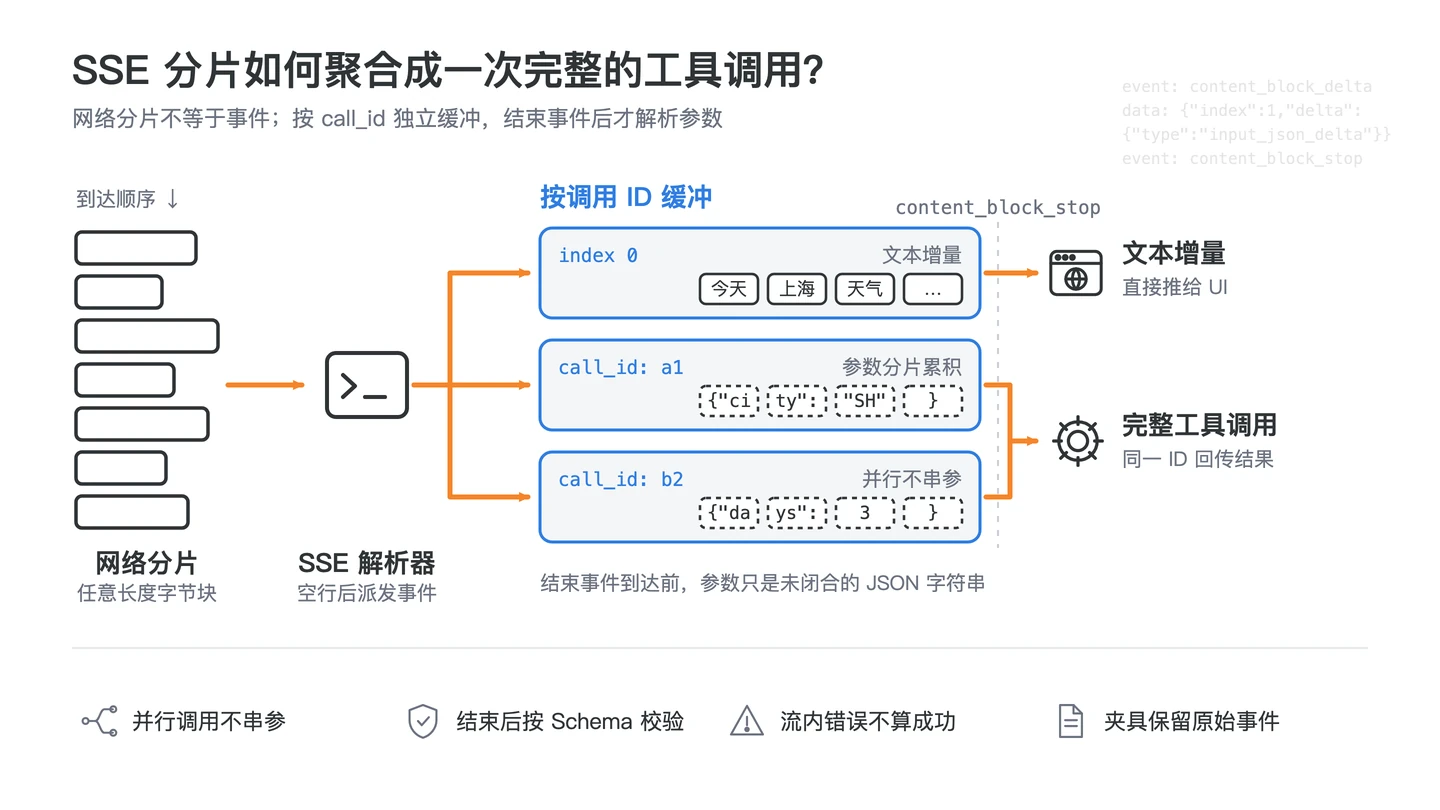
先说结论: 网络分片、SSE 事件、协议事件和 UI 更新是四个不同层次。正确实现应先解析 SSE,再按 Provider 协议构建状态机,最后输出统一的内部事件。测试时必须保留原始事件序列,并覆盖参数分片、并行工具、未知事件、流内错误、断线和取消。
SSE 状态机:先分清四个容易混淆的层次
| 层次 | 看到的对象 | 正确处理 |
|---|---|---|
| TCP 或 HTTP 分片 | 任意长度的字节块 | 只负责重组传输,不假定事件边界 |
| SSE | event:、data:、空行和注释 |
按 SSE 规范解析完整事件 |
| Provider 协议 | response、message、content block、tool call | 按官方事件语义维护状态 |
| 应用内部事件 | 文本增量、工具参数、完成、错误 | 供 UI 和业务订阅的稳定契约 |
一个 SSE 事件可能被拆成多个网络分片,多个事件也可能一起到达。若代码把每个 read() 结果直接当成 JSON,换到 CDN、代理或不同网络后就会随机失败。
API 流式输出必须保留哪些 SSE 语义?
- 正确的响应 Content-Type 与字符编码;
event、data、注释和空行边界;- 消息或响应开始、内容块开始、增量、内容块结束;
- 文本、工具参数、用量和状态更新;
- 正常结束、未完成、取消和流内错误;
- 客户端断开后的资源释放与可追踪记录。
Anthropic Messages 流式文档明确给出 message_start、内容块事件、message_delta 和 message_stop 顺序,并说明流内可能出现错误和未知事件。OpenAI Responses API 则包含带类型和序号的多种事件。中转层可以做内部统一,但不能丢掉影响客户端判断的状态。
工具调用为什么必须按状态机聚合?
工具参数在流式期间可能只是尚未闭合的 JSON 字符串。Anthropic 官方文档明确说明,tool_use 的输入增量是 partial JSON,最终输入才是对象。并行工具调用时,多组参数还可能交错到达。
正确流程是:
- 收到内容块或工具调用开始事件,按
index和call_id建立独立缓冲区。 - 文本增量追加到文本块,参数增量追加到对应工具缓冲区。
- 未收到该工具的结束事件前,不把参数当作完整 JSON。
- 内容块结束后解析一次完整参数,并按 Schema 验证。
- 执行工具时保留
call_id,工具结果使用同一 ID 回传。 - 收到最终完成、错误或取消后关闭本次状态机。
不要把所有工具增量拼到一个字符串,也不要用函数名代替调用 ID。同一个函数可以在一次响应中被调用多次。
Anthropic、Responses 与 Chat Completions 的协议状态怎样对齐?
封面的四段状态是SSE 分帧 → 调用聚合 → 工具结果 → 完成或错误。三套协议都经过这四段,但事件名、关联键和结果回传形状不同,不能声称可无损互转。
| 维度 | Anthropic Messages | OpenAI Responses | OpenAI Chat Completions |
|---|---|---|---|
| 顶层事件 | message_* / content_block_* | response.* typed events | chat.completion.chunk |
| 参数增量 | input_json_delta.partial_json | response.function_call_arguments.delta | choices[].delta.tool_calls[] |
| 结果回传 | tool_result + tool_use_id | function_call_output + call_id | role: tool + tool_call_id |
| 完成语义 | message_stop 与 stop reason | response.completed / item done | 最终 chunk 与 finish_reason |
实现时还要分别验证 Chat Completions tool_calls、Anthropic 的 tool_use 与 tool_result,以及 stream + include_usage 在取消时的边界。威胁边界不仅是解析正确性:错误关联可能让工具结果发给错误调用,重放可能重复写库或发送消息。无法证明调用 ID 与结果一一对应时,必须阻断副作用,而不是“尽量继续”。
一套可执行的 12 组回归测试
| 编号 | 用例 | 通过标准 |
|---|---|---|
| 1 | 短文本流 | 开始、增量、完成顺序正确 |
| 2 | 长文本流 | 无整段缓冲、截断或内存持续增长 |
| 3 | 任意网络分片 | 每个字符位置拆分后仍能解析 |
| 4 | 多事件合并 | 同一分片内多个事件全部处理 |
| 5 | keep-alive 与空行 | 不产生伪文本或 JSON 错误 |
| 6 | 单工具调用 | 名称、ID、参数和结果可关联 |
| 7 | 并行工具调用 | 每个调用独立聚合,不串参数 |
| 8 | 参数 JSON 分片 | 结束后可解析,字符不丢不重 |
| 9 | 工具执行失败 | 结果可回传或任务明确终止 |
| 10 | 流内错误 | 保留机器可读错误,不伪装成正常文本 |
| 11 | 未知事件 | 记录并安全忽略,不破坏已知状态 |
| 12 | 主动取消和断线 | 停止输出、释放资源、状态可追踪 |
测试夹具应保存原始 SSE 字节、解析后的 Provider 事件和内部规范化事件。只有最终文字的快照无法定位是哪一层丢失了信息。
最小测试夹具应该长什么样?
下面是结构示意,不绑定具体 Provider:
{
  "case": "parallel-tools-with-chunked-json",
  "input_hash": "sha256:...",
  "provider": "candidate-gateway",
  "protocol": "responses",
  "raw_fixture": "fixtures/case-07.sse",
  "assertions": {
    "stream_completed": true,
    "tool_call_count": 2,
    "call_ids_unique": true,
    "arguments_valid_json": true,
    "unknown_events_tolerated": true
  }
}
真实测试记录还应包含 SDK 版本、模型 ID、时间、请求 ID、状态码、TTFT、总耗时和用量。敏感提示词、密钥与工具结果必须脱敏。
错误为什么不能伪装成正常结束?
如果上游在流内发出错误,中转站应映射为可识别的错误状态,并保留请求 ID 与原始错误类型。把错误文字塞进 assistant 内容,会让客户端把失败写入业务数据库或继续执行下一步工具。
同样,响应已经产生文本或工具副作用后,通常不能无条件切到另一个模型并重放。是否可重试取决于请求是否幂等、是否已输出内容、工具是否执行,以及业务是否允许重复。详细策略见 API 重试、熔断与故障切换。
怎样测试流式取消和代理缓冲?
主动取消
在收到若干事件后关闭客户端连接。检查网关是否感知断开、停止写入、取消或关闭上游连接、释放并发槽位,并给日志留下 cancelled 或等价状态。不能凭下游停止显示就断定上游已经停止计费。
慢客户端与背压
故意降低读取速度,观察内存、队列和超时。网关应有有界缓冲与明确策略,不能无限堆积,也不能在没有记录的情况下静默丢事件。
反向代理缓冲
分别直连网关和经过 CDN、负载均衡或反向代理测试。比较首事件时间和事件边界,确认代理没有把完整响应缓存后一次返回。
用量和账单应该怎样处理?
不同协议可能在流结束、消息更新或最终响应中提供累计用量。网关应明确用量是上游返回、内部估算还是暂不可用。中途取消或网络断线时,没有完整数据就标记“不完整”,不能用猜测 Token 冒充实测。
按请求 ID 关联模型、成功状态、输入输出 Token、缓存、费用和重试次数。异常账单可进一步使用 API 中转站倍率与费用核对 排查。
兼容失败时怎样降级与回滚?
| 观察到的状态 | 能力声明 | 隔离与回滚动作 |
|---|---|---|
| 只有最终文本,事件被整段缓冲 | 不得标记 streaming | 绕过缓冲代理或切回已验证直连路径 |
| 文本可流式,但调用 ID 丢失 | 只标 chat-only | 关闭工具路由,禁止任何写操作 |
| Responses 被降成 Chat chunk | 明确列出语义降级 | 客户端回到原 wire API,不静默猜测 |
| 取消后缺少最终 usage | 标记 incomplete | 用请求 ID 向上游记录核对,不补估算值 |
| 新事件使解析器崩溃 | 兼容门禁失败 | 保留原始夹具,回滚解析器并补前向兼容测试 |
供应商验收时,要求提供实际支持的协议与事件列表、取消传播、错误映射、版本变更和回滚说明。测试使用独立最小权限 Key,并落实日志脱敏:过滤鉴权头、提示词与工具参数;验收结束后轮换或撤销测试凭据。
上线前的协议验收清单
- 原始 HTTP 与官方 SDK 两条路径都通过;
- 12 组用例在直连和生产代理链路中通过;
- 未知可选字段与事件不会让解析器崩溃;
- 错误、取消和未完成状态不会被记为成功;
- 工具 ID、参数、结果和副作用有端到端追踪;
- 日志不含完整 Key 和不必要的请求正文;
- 事件夹具进入 CI,模型、SDK 或网关升级前自动回归。
整体迁移流程见 OpenAI 兼容 API 迁移指南,分层排错见 API 中转站错误码指南,生产观测字段见 API 网关可观测性。
GPTZZZ 的关系与适用边界
GPTZZZ 不是 OpenAI 或 Anthropic 的官方服务,与其不存在隶属关系。GPTZZZ 提供独立的多模型 API 服务。本文依据公开协议说明通用测试方法,不保证不同 Provider 的事件名称完全一致;实施时应以目标 Provider 当日文档和实际原始事件为准。
可复现:保存原始 SSE 请求、响应与解析指标
下面用 OpenAI Responses streaming 形状演示采集方法;Anthropic Messages 与 Chat Completions 应各保存一份独立夹具,不能套用同一事件断言。测试 Key 必须是最小权限、低额度、可撤销凭据。
set +x
: "${LAB_BASE_URL:?set LAB_BASE_URL}"
: "${LAB_API_TOKEN:?set LAB_API_TOKEN}"
mkdir -p .work
printf 'header = "Authorization: Bearer %s"\n' "${LAB_API_TOKEN}" | \
curl --config - --silent --show-error --no-buffer \
  --request POST "${LAB_BASE_URL%/}/v1/responses" \
  --header "Accept: text/event-stream" \
  --header "Content-Type: application/json" \
  --data '{"model":"lab-model","stream":true,"input":"Return one function call for ping with value 1","tools":[{"type":"function","name":"ping","description":"Echo a number","parameters":{"type":"object","properties":{"value":{"type":"integer"}},"required":["value"],"additionalProperties":false},"strict":true}]}' \
  | tee .work/responses-tool-call.sse
夹具中至少应能观察到以下响应事件关键字段。为便于阅读这里只节选事件,response 对象也只展示 ID 与状态;实际回归必须保存并校验完整对象,不能把节选当作可重放夹具。ID、序号和参数仅为示意:
event: response.created
data: {"type":"response.created","sequence_number":0,"response":{"id":"resp_example"}}

event: response.function_call_arguments.delta
data: {"type":"response.function_call_arguments.delta","item_id":"item_example","output_index":0,"sequence_number":1,"delta":"{\"value\":"}

event: response.function_call_arguments.done
data: {"type":"response.function_call_arguments.done","item_id":"item_example","output_index":0,"sequence_number":2,"name":"ping","arguments":"{\"value\":1}"}

event: response.completed
data: {"type":"response.completed","sequence_number":3,"response":{"id":"resp_example","status":"completed"}}
| 参数边界 | 验证指标 | 错误或失败模式 |
|---|---|---|
| SSE 只在空行后派发,网络 chunk 不等于事件 | 解析事件数、空事件数、非法 JSON 数 | 逐次 read() 解析会随机截断或并包 |
| 每个 index / call ID 独立缓冲 | 调用数、ID 唯一率、参数 Schema 通过率 | 并行调用串参,或在 done 前解析 partial JSON |
| 取消和背压必须有有界策略 | 取消传播耗时、峰值缓冲、连接释放数 | 客户端停止显示但上游仍运行,或内存持续增长 |
| 未知事件可记录并前向兼容 | unknown event 数、已知状态完成率 | 新增事件导致崩溃,或被当作普通文本 |
故障排查与回滚:分别对直连、反向代理和 CDN 路径重放同一夹具;若只有代理路径一次性吐完,先关闭缓冲或绕过该层。若调用 ID、完成状态或流内错误无法保留,立即关闭工具执行并降级为 chat-only,回滚到已验证 wire API。
参考资料
- WHATWG:Server-Sent Events
- Anthropic:Streaming Messages
- Anthropic Messages API
- OpenAI Responses Streaming Events
- OpenAI:Function calling
- OpenAI Chat Completions Streaming Events
- OpenAI API Overview:兼容性
常见问题
SSE 是不是逐行 JSON?
不是。SSE 以 UTF-8 文本、字段行和空行构成事件;网络读取块也不等于事件边界。应先完成 SSE 分帧,再解析 data 中的协议对象。
Anthropic 和 OpenAI 的工具参数都能边收边解析吗?
参数增量通常只是未闭合字符串。应按内容块索引或调用 ID 分别累计,在对应完成事件后再解析并按 Schema 验证。
为什么工具调用比普通聊天更容易暴露中转兼容问题?
工具链还依赖调用 ID、参数分片、并行顺序、工具结果回传和结束状态;遗漏任一关联字段,都可能让文字正常而工具循环中断。
为什么取消后可能看不到完整 usage?
流被中断时,携带最终用量的事件可能尚未到达。此时应标记用量不完整,并以后端或上游最终记录核对,不能自行补数。
兼容层丢失调用 ID 时应该继续执行工具吗?
不应该。无法证明调用与结果一一对应时,应阻断工具执行,把能力降级为 chat-only,并回退到已验证协议路径。
模型名称、价格与可用性会变化,请以 GPTZZZ 控制台的实时信息为准。