Claude Code 中转站怎么选:九项可验证的判断标准
市面上的 Claude Code 中转站大多只公布倍率和模型列表,而这两项恰恰最容易写好看。真正决定能不能长期用下去的是协议兼容性、模型真实性、故障时的行为,以及出问题时能不能带着配置走。这九项都能在下单前自己测出来。
为什么价格不该是第一判断标准
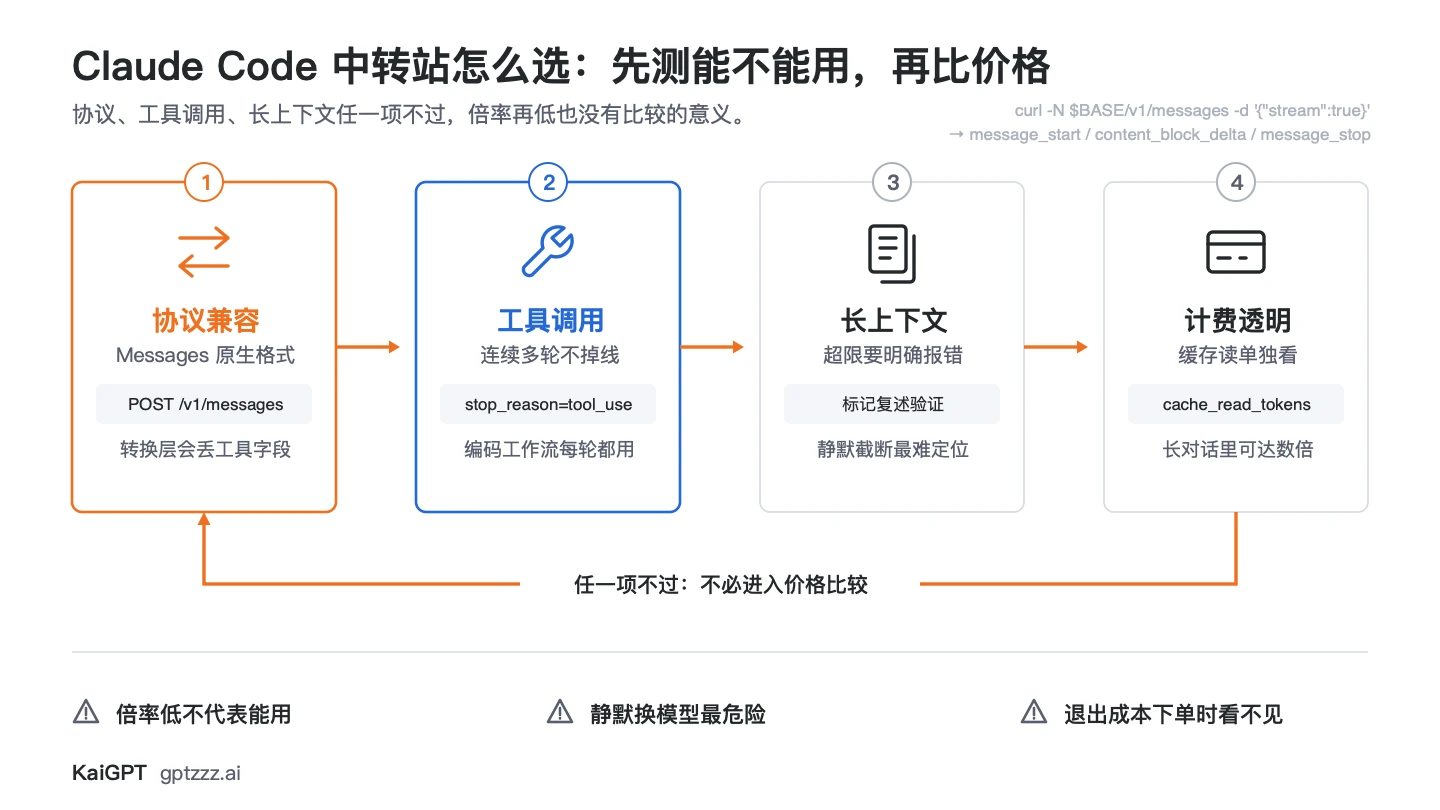
中转站的成本结构里,上游调用费是刚性的。报价明显低于上游成本时,差额只可能来自三处:用更便宜的模型顶替、压缩上下文、或者靠后续涨价与跑路补回来。
这三种都不会写在价格页上,但都能测出来。本文后面几节就是测法。
判断顺序应当是:先测能不能用,再测稳不稳,最后才比价格。反过来做,你会为一个跑不通工具调用的网关付一年的钱。
协议兼容性:Claude Code 要的是 Messages 格式
Claude Code 走 Anthropic Messages 协议,不是 OpenAI Chat Completions。有些网关只做了 OpenAI 兼容层,宣传里写「支持 Claude 模型」,实际是把 Messages 请求转成 Chat Completions 再转回来。
这种转换会在三个地方露馅:
| 现象 | 说明 |
|---|---|
| 工具调用参数结构对不上 | Messages 的 tool_use 与 Chat Completions 的 tool_calls 字段不同,转换层容易丢字段 |
| 系统提示被合并进第一条用户消息 | Messages 的 system 是顶层字段,转换后位置变了,长对话里行为会漂 |
| 流式事件类型缺失 | Messages 的 SSE 有细分事件,转换层通常只回文本增量 |
验证方法是直接发一个原生 Messages 流式请求,看返回的事件类型是否完整:
curl -N https://你的网关/v1/messages \
  -H "x-api-key: $KEY" \
  -H "anthropic-version: 2023-06-01" \
  -H "content-type: application/json" \
  -d '{"model":"你的模型ID","max_tokens":64,"stream":true,
       "messages":[{"role":"user","content":"数到三"}]}'
回来的流里应当出现 message_start、content_block_start、content_block_delta、content_block_stop、message_delta、message_stop。只有简化的文本增量结构,说明中间做了协议转换。具体配置见Claude Code 中转站配置。
模型真实性:ID 对得上不等于模型对得上
模型 ID 是网关自己填的字符串,写什么都行。要确认背后是不是你以为的模型,用三个交叉验证。
第一,看报错信息。故意发一个该模型不支持的参数值,上游的原始报错常常会暴露真实模型名。比如对不支持某个 reasoning 档位的模型发送该值,错误信息里通常会带上游的真实模型标识。
第二,看 usage 字段的构成。不同代次的模型返回的 usage 结构不同,有的有缓存读字段,有的有推理 token 字段。结构对不上说明模型不对。
第三,用知识截止点探。问一个特定时间点之后才发生的事。这个方法不精确,只能作为旁证。
更完整的方法见模型真实性核验。
流式与工具调用:Claude Code 的刚需
Claude Code 在实际工作中几乎每一轮都会用到工具调用,读文件、改文件、跑命令都是。工具调用不稳,整个工作流就废了。
| 测试项 | 判断标准 |
|---|---|
| 单次工具调用 | stop_reason 应为 tool_use,且参数能正确解析 |
| 多轮工具调用 | 连续三到五轮工具往返不掉线、不丢上下文 |
| 流式下的工具调用 | 流式模式下工具参数仍能完整拼出,不截断 |
| 长上下文 | 塞到接近上限时不静默截断,超限应明确报错 |
最后一项尤其重要。有的网关在超出实际支持的上下文时会静默截断而不报错,表现是模型突然「忘记」前面的内容。这种问题在开发时极难定位。测法是发送一段带明确标记的长文本,在末尾要求复述开头的标记。标记回不来但也没报错,就是静默截断。
稳定性:看故障时的行为,不是可用率数字
任何网关都会有故障,区别在于故障时它怎么表现。
| 情况 | 好的表现 | 差的表现 |
|---|---|---|
| 上游超时 | 明确返回 5xx 或超时错误 | 挂住连接直到客户端超时 |
| 上游限流 | 透传 429 并带 retry-after | 转成 500,或静默重试到超时 |
| 模型不可用 | 返回明确的 model_not_found | 静默切换到另一个模型 |
| 流式中断 | 发出错误事件后关闭 | 直接断开,客户端无法区分正常结束 |
静默切换模型是最需要警惕的一项。它让故障变得不可见,你会以为一切正常,直到发现输出质量莫名下降。测法是在用量高峰期连续发起请求,观察返回的 model 字段是否始终与请求的一致。相关方法见稳定性基准测试。
计费透明度:三个必须能查到的数字
一个可核对的计费至少要能查到三项:单次请求的 token 用量(分输入、输出、缓存读、缓存写)、该次请求的计费金额与计价口径、以及可导出的历史明细。三者缺一就无法验证账单。
一个常被忽略的点是缓存读的计价。长对话里缓存读的 token 量可能是输入 token 的几倍,如果口径不清楚,账单会比预期高出很多。下单前先问清楚缓存读怎么算。
倍率与账单复算的细节见中转站倍率是什么意思。
数据边界:读一遍它的隐私说明
中转站在技术上能看到你发送的全部内容,包括代码、提示词和工具调用结果。用 Claude Code 意味着你的项目代码会流经它。
至少确认三件事:是否记录请求正文、记录多久、谁能访问;是否用于训练,自己训练还是转给上游;上游是谁,是官方 API 还是另一层中转。
第三点最容易被模糊带过。多层中转意味着数据经过更多不受控环节,而且故障排查会变得非常困难。展开见中转站的数据安全与隐私边界。
退出成本:能不能带着配置走
这一项在下单时没人关心,出问题时最要命。
好的信号是:用标准的 ANTHROPIC_BASE_URL 加标准鉴权头,模型 ID 与上游一致或有明确映射表。这样换回官方端点或换另一家,只需要改一个环境变量。
差的信号是:要求安装专有客户端、用自定义鉴权方式、模型 ID 是自创命名。这些都会把你锁住。
一个简单的测试:把网关配置从环境变量里移除,恢复官方配置,看 Claude Code 能不能立刻正常工作。不能的话,说明它改动了你环境里的其他东西。回退策略见重试、退避与回退。
一张可以直接用的核对表
下单前按这个顺序走一遍,任何一项不过就不要继续。
| 顺序 | 检查项 | 不通过的表现 |
|---|---|---|
| 1 | 原生 Messages 流式事件完整 | 只有简化的文本增量 |
| 2 | 工具调用连续多轮稳定 | 三轮内出错或丢上下文 |
| 3 | 长上下文不静默截断 | 标记回不来但不报错 |
| 4 | 返回的 model 字段始终一致 | 高峰期悄悄换模型 |
| 5 | 错误码语义正确 | 429 被转成 500 |
| 6 | 用量明细可导出且分项清晰 | 只有总额没有构成 |
| 7 | 缓存读计价口径明确 | 问不出来或含糊 |
| 8 | 隐私说明写明日志与训练 | 没有隐私页 |
| 9 | 标准环境变量可一键回退 | 要装专有客户端 |
前三项测不通过的,价格再低也不能用,因为 Claude Code 跑不起来。
常见问题
倍率越低越好吗?
倍率只反映价格,不反映可用性。一个倍率很低但工具调用不稳的网关,实际成本高于倍率略高但稳定的。应当先通过协议兼容性、工具调用、长上下文三项,再比倍率。
需要自己搭中转吗?
自建能完全掌控数据边界和故障行为,代价是要自己维护上游账号、限流、重试和监控。团队规模小、调用量不大时,自建的维护成本通常高于直接使用现成服务。
怎么快速判断一家是不是多层中转?
看延迟和错误格式。多一层中转通常多 200 毫秒以上的固定延迟;错误信息被包了两层、格式不是上游原生的,也是信号。
继续阅读
Claude Code 中转站配置:API、Base URL 与验证
环境变量与 Base URL 配置,验证模型、流式响应和工具调用,并给出密钥保护与回退检查。
API 中转站选型核对清单
按数据等级、限额、可验证账单、稳定性证据与退出路径逐项核对。