中转站模型真假与掺水检测:怎么核对是不是你付费的模型
中转站给的是不是你付费的那个模型?只问“你是谁”没用。本文用模型目录、协议能力、重复探针和账单交叉核对,结论分为一致、不一致、漂移和未验证四级。
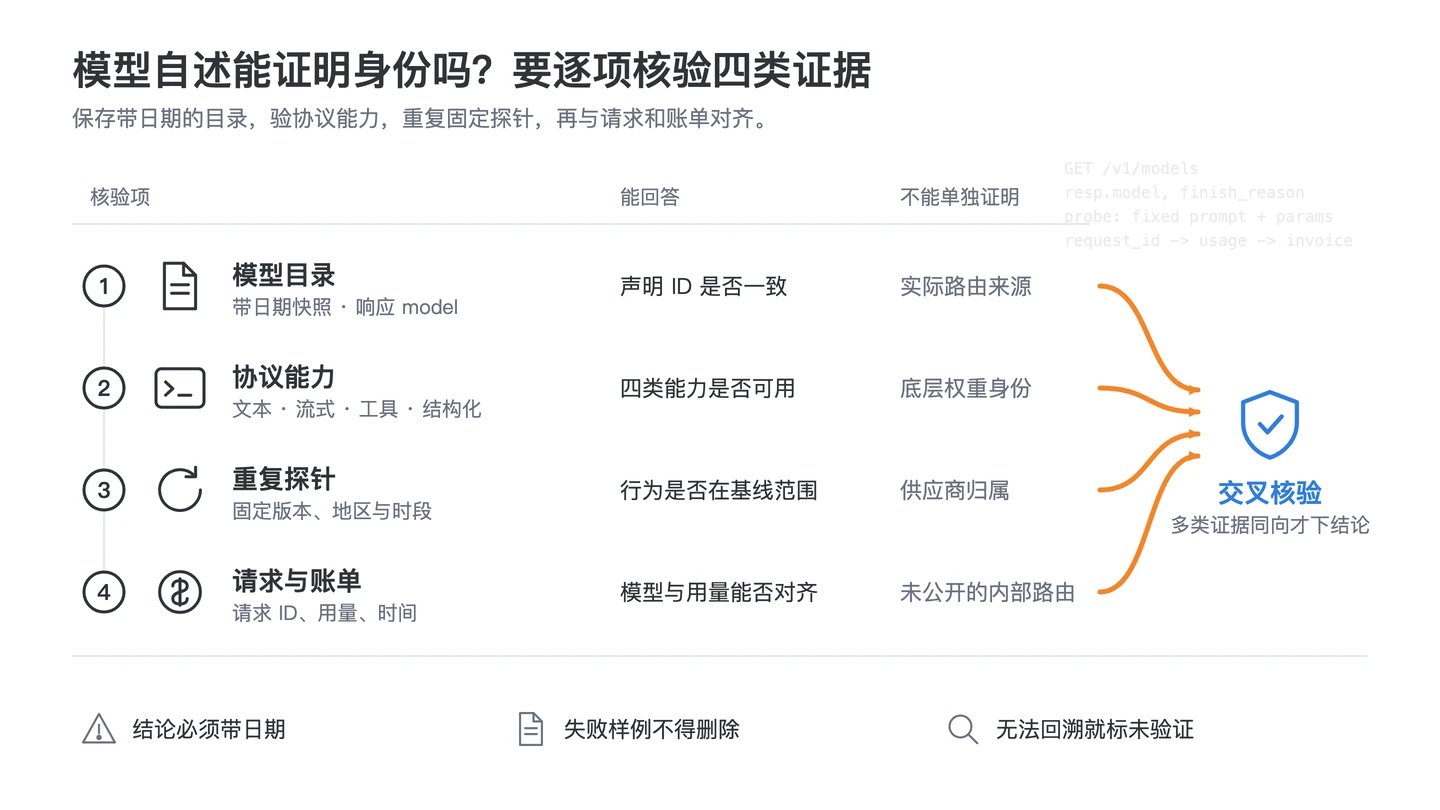
核验模型身份时,单次自述、文风或知识问答不能证明上游身份;应保存模型目录,验证协议能力,重复固定探针,再用请求元数据与账单交叉核验。
先给结论:模型真假能核对到什么程度
可验证的是“在某日期、端点和条件下观察到的声明与行为是否一致”,而不是从输出反推出不可见基础设施的数学证明。响应中的 model 是证据之一,但网关可以映射别名;模型自述受系统提示和训练材料影响,权重很低。
“掺水”不是标准技术术语。常说的掺水可以拆成四类能查的问题:模型映射或路由变了、协议能力缺失、内容质量相对基线回归、计费与用量对不上。下表每种证据只回答其中一部分。
| 证据 | 能回答 | 不能单独证明 |
|---|---|---|
| 模型目录与响应 model | 声明 ID 是否前后一致 | 实际路由来源 |
| 协议能力矩阵 | 工具、结构化输出、流式是否可用 | 底层权重身份 |
| 重复 eval | 行为是否在基线范围 | 供应商归属 |
| 请求与账单 | 模型、用量、时间能否对齐 | 未公开的内部路由 |
可复现的模型目录与探针命令
export RELAY_BASE_URL="https://relay.example/v1"
export TEST_KEY="replace-with-lab-key"
export MODEL_ID="replace-with-declared-model-id"
curl -sS "$RELAY_BASE_URL/models" -H "Authorization: Bearer $TEST_KEY" > models-2026-08-27.json
curl -sS -D probe-headers.txt "$RELAY_BASE_URL/chat/completions"   -H "Authorization: Bearer $TEST_KEY" -H "Content-Type: application/json"   --data "{\"model\":\"$MODEL_ID\",\"messages\":[{\"role\":\"user\",\"content\":\"Reply with exactly: ok\"}],\"temperature\":0,\"max_tokens\":8}"   -o probe-response.json
python3 -m json.tool probe-response.json
目录文件名必须带日期;探针保存最终 URL、响应头、响应 model、结束原因、usage 和脱敏请求 ID。厂商字段是否被兼容网关透传要以实测为准,缺失字段应记录为“未观察到”,不能补造。
协议能力与重复评测矩阵
- 普通文本:固定提示词、温度、输出上限,验证解析与结束原因。
- 流式:记录该模型能否正常流式返回及事件完成状态;事件顺序、结束事件和未知事件的核对方法见检测篇的校验清单。
- 工具调用:只用无副作用测试工具,核对参数 schema 和调用 ID。
- 结构化输出:验证声明 schema、拒答和截断时的行为。
- 漂移探针:按固定版本、地区和时段重复,记录通过/失败而非只留主观感受。
先固定客户端与网络条件,再参考流式与工具调用兼容性拆分协议结果。
具体验证清单
- 保存带日期的模型目录、请求模板和文档版本。
- 记录声明模型 ID 与每次响应 model 字段,不把别名自动等同于 snapshot。
- 普通、流式、工具、结构化输出各留一份可解析证据。
- 固定提示词、参数、SDK、地区和时段,至少跨两个批次重复。
- 把内容质量 eval 与协议身份证据分列。
- 按请求 ID、模型、时间和用量连接账单;差异进入人工核验。
OpenAI 的兼容性说明强调模型输出本质上会变化,追求稳定行为时应固定模型版本并维护 eval。因此“输出不同”是触发调查的信号,不是替换模型的单次定论。
故障定位路径:声明 → 协议 → 行为 → 账单
先查目录和响应模型字段是否突变;再看协议能力是否只在某路由或模式失败;随后对固定探针做时间序列比较;最后核对请求元数据与账单。若只有内容质量下降而协议和账单一致,进入模型行为回归;若 model、能力或计费同时变化,要求服务方解释路由和变更。
用API 中转站可观测性连接 trace/request ID 与路由字段,用账单复算核查模型与用量。所有结论都应带日期,不能永久外推。
常见错误与误读
- 问“你是谁”或靠文风、口头禅给模型定性。
- 把知识截止点、一次 benchmark 或检测网站分数当成身份证明。
- 忽略模型别名、snapshot、系统提示和采样随机性。
- 发现一条字段缺失就断言中转伪造,而未核查兼容层是否透传。
- 把内容质量回归、协议不兼容、路由变化和计费差异混成“掺水”。
本文的限制是只能建立行为与记录证据链,不能从黑盒输出证明不可见基础设施,也不对任何供应商作真实性背书。
评测集、基线与漂移管理
评测集至少分为协议样例与业务样例。协议样例只判断可解析、字段、工具参数、schema 和结束事件;业务样例由人工或确定性规则判断任务是否完成。每条样例保存稳定 ID、提示词版本、期望约束、允许变体、评分器版本和是否含副作用。不要把测试答案、密钥或真实用户内容放进公共仓库。
建立基线时选择一个明确日期和声明版本,在同一客户端、地区、系统提示与采样参数下运行多个批次。保存逐请求结果,而不是只留平均分。对非确定性输出,优先记录约束通过率、工具参数合法性、拒答类别和结构化解析结果;文风或措辞相似度只能作弱信号。模型官方版本变更、系统提示调整或评测器升级后,基线必须升版。
漂移告警需要预先定义触发条件,例如“同一协议项连续多个批次失败”或“多个互不相关任务同时偏离基线”,但阈值由样本与业务风险配置,本文不提供通用数值。告警后先重跑控制样例,排除网络、超时、客户端解析与网关参数改写;再检查目录/response model、协议矩阵、路由记录和账单。只有多类证据同向变化,才升级为模型映射调查。
审查结论使用分级词:一致表示当前证据符合声明;不一致表示某个可验证字段或能力明确冲突;漂移表示行为相对历史基线变化;未验证表示证据缺失。不要把这些词自动改写成“真模型/假模型”。服务方给出解释后,应把说明、文档版本和复测结果并列保存,避免只保留单方结论。
最后做可重复性复核:另一位执行者只读 README 和环境占位符,能生成相同结构的目录快照、响应包和评分表;随机抽取记录能从报告回溯到请求,再回溯到账单或路由日志。无法回溯的高分不进入身份结论,失败样例也不得因不符合预期而从数据集中删除。
身份核验记录表:请求、响应与参数
模型身份核验的请求边界是固定模型 ID、端点、消息/工具 schema、系统提示、SDK 版本和测试集版本;响应边界是响应 model、结束原因、工具参数、结构化解析、事件序列、usage 与请求 ID。温度、seed(若接口支持)、最大输出、地区和时段都是参数边界;接口未声明支持的参数不得假定生效,兼容层是否透传供应商字段也必须记录为观察结果。
| 证据阶段 | 请求/参数边界 | 响应证据 | 失败模式 | 验证指标与处置 |
|---|---|---|---|---|
| 目录与声明 | 保存日期、Base URL、目录接口与声明模型 | 目录快照、响应 model、文档版本 | 别名漂移、字段映射、目录与响应冲突 | 声明一致率只作证据层;冲突时停止身份结论 |
| 协议能力 | 固定文本、流式、工具和 schema 四类样例 | 解析结果、调用 ID、事件完成状态 | 部分兼容、未知事件、工具参数失真 | 按能力项统计约束通过率,失败样例不得删除 |
| 重复 eval 与账单 | 同一版本跨批次复测,冻结评分器 | 逐请求评分、usage、账单和路由说明 | 评分器升级、样本污染、账单时间错位 | 模型输出漂移触发复核,不自动等于模型替换 |
在 AI API 中转场景,“模型名称和实际能力不一致怎么办”应先拆成声明、协议、行为和计费四条可证伪命题。另一位执行者应能从 README 复现请求包,并从每条结论回溯到响应与账单;无法回溯就标为未验证。若控制样例也失败,先回滚客户端、请求模板与评分器,再谈模型映射。
一手资料
停止、回滚与恢复步骤
出现目录突变、协议样例大面积失败、账单无法对齐、评测器版本混用或测试工具产生副作用时停止身份结论。冻结当前证据目录,撤销测试 key,并把状态标为“未验证”,不能回滚数据去隐藏异常。回滚到已归档的模型目录、请求模板、eval 数据集和评分器版本,用控制样例确认客户端与网关正常;恢复时先跑协议矩阵,再跑小批业务 eval,最后恢复漂移监控。若新旧基线不可比较,就升版而不是拼接分数。
执行问题与参数边界
以下回答用于定位常见执行问题。实际判断仍需结合本文的参数、失败模式和验证指标,不应仅凭一项现象推断服务能力。
API 模型检测怎么做
用中转站模型检测的证据链,而不是让模型自述身份。
中转站怎么判断实际模型
模型身份核验要连接目录、协议、重复 eval 和账单。
API 返回的模型 ID 是否可信
模型 ID 是证据之一,不能单独证明 API 模型真实性。
如何验证 AI API 模型版本
保存模型版本、文档版本、端点与日期后重复测试。
中转站模型能力如何重复测试
模型能力测试应固定提示词、参数、SDK、地区和时段。
模型身份核验需要哪些证据
至少需要目录、响应字段、协议能力、请求 ID、重复 eval 与账单。
常见问题
中转站模型真假怎么检测?
保存带日期的模型目录与响应字段,分别验证普通、流式、工具和结构化输出,再用固定 eval 重复测试,并把请求 ID、模型、用量与账单交叉核验。
响应中的 model 字段能单独证明上游吗?
不能。它只能证明该响应声明了什么,仍需与目录、协议能力、重复评测、请求元数据和账单形成证据链。
问模型“你是谁”为什么不可靠?
模型自述可能受系统提示、训练材料和网关改写影响,也未必知道实际部署版本,因此只能算弱信号。
发现模型输出漂移怎么办?
先固定提示词、参数、版本、SDK、地区和时段重跑 eval;若变化持续,再核对官方变更说明、路由记录和账单,不用单次输出直接下身份结论。
文中对 OpenAI 模型版本说明和 OpenAI、Anthropic 流式文档的引用核验于 2026-10-10。模型、接口和文档会变,上线前请按当前文档和你自己的请求记录重新验证。