API 中转站上游渠道有哪些?官转、号池、逆向怎么分辨
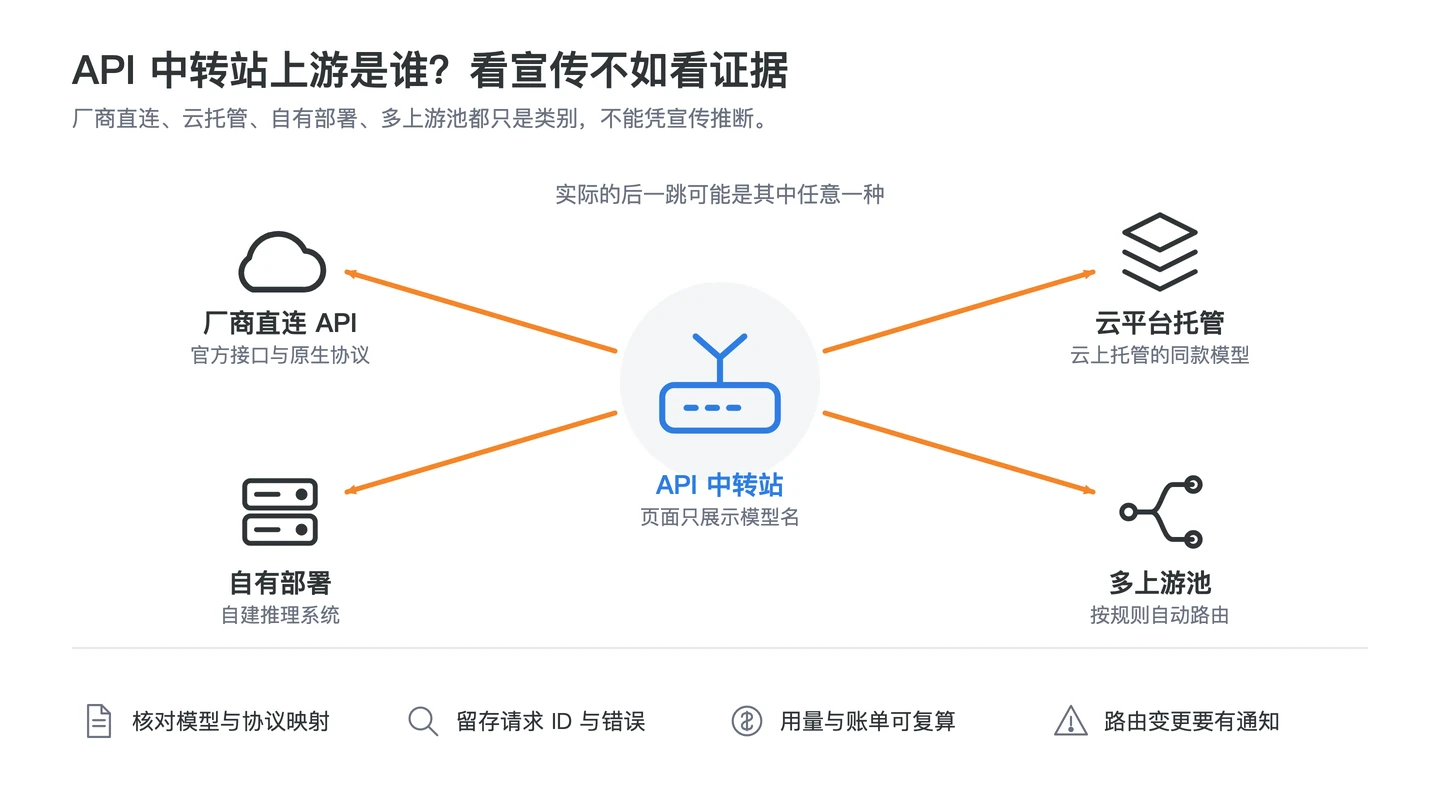
中转站上游一般分四类:官方 API Key 按量转发(官转);Amazon Bedrock、Google Cloud、Microsoft Foundry 等云厂商渠道;ChatGPT、Claude 消费订阅凑成的号池;逆向的网页端或 IDE 额度。售价比官方按量价(按当日汇率折成人民币)低得越多,越不可能是官转。从外部做的检查大多只是线索;书面答复能让服务商承担责任,真正能确认路径的只有你自己能核对的厂商账单(自带 Key)。
中转站上游速查:四类渠道对照
同一个模型名,背后可能是完全不同的上游。下表按来源、稳定性、条款风险、价格和识别方法对照,条款原文出处见下一节。
| 上游类型 | 来源 | 稳定性 | 条款风险 | 价格特征 | 怎么识别 |
|---|---|---|---|---|---|
| 官方 API Key 转发(官转) | 中转方在厂商开发者平台开通的按量 API Key | 与厂商 API 一致,受该 Key 所在组织的速率档位限制 | 相对最低;能否转售取决于中转方与厂商的商业协议 | 成本底线接近官方按量价,售价远低于官方价时很难覆盖成本 | 参数和功能完整,错误体、请求 ID 和限流头与官方文档一致 |
| 云厂商渠道 | Amazon Bedrock、Google Cloud Gemini Enterprise Agent Platform(原 Vertex AI)、Microsoft Foundry 上托管的模型 | 由云平台配额和区域决定,部分功能与厂商直连不同 | 较低;能否转售取决于中转方与云平台及模型厂商的条款 | 按云平台价目;售价远低于云上价目同样需要解释 | 功能缺口与云平台文档一致,可能透出 apim-request-id(Microsoft Foundry)或 X-Amzn-Bedrock-* 等云端响应头 |
| 订阅号池 | 多个 ChatGPT Plus/Pro、Claude Pro/Max 等消费订阅账号的登录凭据或会话 | 受单账号用量上限和风控影响,账号被限后会排队、换号或突发失败 | 高:OpenAI、Anthropic 的消费者条款都禁止分享账户凭据 | 可远低于官方按量价,因为成本是固定月费摊到大量请求上 | 分组名带 Plus、Pro、Max、号池、订阅等字样;价格只有官方零头;限流更像单账号用量窗口(排队、换号、突发失败),而不是按请求数和 Token 速率返回 429 |
| 逆向 / IDE 额度 | 模拟网页端或 IDE、编程助手的私有接口,把订阅里的模型额度包装成 API | 最低:客户端协议一改或账号被封,整批失效 | 高:OpenAI 条款禁止逆向工程,Kiro 定价页明确不允许绕开原生界面使用订阅 | 通常明显低于官方按量价 | 官方支持的采样参数(以该模型官方文档为准)被静默忽略、上下文明显短于官方、回复里出现 IDE 或网页端的人设和工具说明 |
“怎么识别”一栏都是线索,不是证明:中转方可以改写响应字段,也可以删除或伪造响应头。一家中转站也常常同时混用几类上游,要按分组逐个判断。
四类上游的细节与官方条款
官方 API Key 转发(官转)
中转方用自己在 OpenAI、Anthropic、Google 等厂商开发者平台开通的按量 Key 调用模型,再按自己的价目卖给你。请求和响应格式与官方一致,官方文档里的响应头通常也能对上:OpenAI API 返回 x-request-id、openai-processing-ms 和 x-ratelimit-* 等头;Claude API 每个响应都带 request-id 头(形如 req_…),并返回 anthropic-ratelimit-* 限流头。中转方可能把这些头删掉,所以“没有”说明不了问题,“有且格式对”才算加分项。
云厂商渠道
三家云平台都托管第三方厂商的模型,但范围不同(按 2026-10-09 的官方页面):
- Amazon Bedrock:Anthropic Claude、OpenAI(GPT-6、GPT-5.x 系列和开放权重的 gpt-oss)、DeepSeek、Qwen、xAI Grok 等;Google 的模型只有开放权重的 Gemma,没有 Gemini。
- Google Cloud Gemini Enterprise Agent Platform:2026-04-22 起 Vertex AI 并入该平台。提供 Gemini,Claude、Grok 等合作模型,以及 DeepSeek、Qwen 等开放模型。Claude 在这里的请求把模型写在 URL 里,请求体带
"anthropic_version": "vertex-2023-10-16"。 - Microsoft Foundry:包含全部 Azure OpenAI 模型,以及 DeepSeek、xAI、Meta、Mistral 等;Claude 也能在 Foundry 部署,通过 Azure Marketplace 计费。
云渠道的识别点主要是“功能缺口”。Anthropic 文档列出 Agent Platform 上的 Claude 不支持 Files API、Message Batches 和 Models API 等;Foundry 不返回 anthropic-ratelimit-* 头,排障时用 request-id 和 apim-request-id。某个中转分组恰好出现同样的缺口,就是云渠道的线索。
订阅号池
号池把多个消费级订阅账号(ChatGPT Plus/Pro、Claude Pro/Max 等)的登录凭据或会话集中起来,替用户发请求。固定月费摊到大量请求上,所以能卖得很便宜。条款上的问题很直接:
- OpenAI 使用条款(2026-01-01 生效,适用于 ChatGPT 等个人服务):不得分享账户凭据或让他人使用你的账户;不得自动或以编程方式提取服务中的数据或输出;不得规避速率限制或其他限制。
- Anthropic 消费者条款(适用于 Free、Pro、Max 用户):不得与他人分享账户登录信息或凭据;除通过 Anthropic API Key 或 Anthropic 明确允许的方式外,不得用机器人、脚本等自动化方式访问服务。
- Claude Code 法律与合规文档:Anthropic 不允许第三方开发者通过 Free、Pro、Max 套餐凭据代用户转发请求,也不允许收集、存储或中转 Claude.ai 凭据和会话 token,并保留不经事先通知采取执行措施的权利。
对使用者的直接影响:账号被限或被封时,请求会排队、换号或直接失败,而且你无法追溯是哪个账号处理了你的请求。
逆向与 IDE 额度
这类上游不走公开 API,而是模拟网页端或 IDE、编程助手客户端的私有接口,把订阅里包含的模型额度转成 API。以 Kiro 为例,它按 credits 计量订阅用量,定价页写明订阅可用于 Kiro IDE、CLI、Web 等原生界面,通过第三方自动化工具把请求路由到原生界面之外的用法不被允许。OpenAI 使用条款也禁止对其服务做逆向工程。客户端一更新协议,或平台识别出异常流量,这类渠道就会整批失效。
合同、数据和地区方面的合规问题,见API 中转站合规风险判断。
怎么查看一个中转站的上游
先接受一个前提:从外部看到的东西都可能被中转方改写。下表大致按操作顺序排列,最后一列标明每项检查的结论强度;只有最后一项能真正下定论。
| 检查 | 怎么做 | 能说明什么 | 结论强度 |
|---|---|---|---|
| 书面询问 | 用工单或邮件问:这个分组的上游是官方 API Key、云平台、订阅号池还是逆向?上游变更时怎么通知? | 明确答复可以追责;拒答或含糊本身也是信息 | 责任依据,不是技术证明 |
| 分组名和倍率对照官方价 | 把站内单价除以官方按量单价,算出官方每 1 美元用量收多少元,再与 1 美元按当日汇率折合的人民币比较(不是与 ¥1 比较) | 明显低于汇率折算价时,按标价付费的官方 Key 覆盖不了成本 | 较强信号(也可能是赠金或补贴) |
| 响应 model 字段和响应头 | 保存完整响应头和响应体,对照官方文档里的头部名称和 ID 格式 | 出现官方或云平台特有的头是线索;没有出现说明不了什么 | 指示性,可被改写 |
| 错误格式 | 发一个不存在的模型名和一个错误参数,看错误体结构和文案 | 与官方结构一致是加分项;“账号繁忙”一类非官方文案值得追问 | 指示性 |
| 限流行为 | 小并发逐步加压,记录 429 出现的时机和有无 retry-after | 官方 API 按请求数和 Token 速率限流;号池更像按单账号用量窗口失败 | 指示性 |
| 参数与功能覆盖 | 测工具调用、结构化输出、长上下文和缓存相关的 usage 字段 | 缺口模式与某个云平台文档一致,或参数被静默忽略 | 较强信号 |
| 自带 Key 或厂商账单 | 服务支持使用你自己的厂商 Key 时,到厂商控制台核对这笔用量 | 用量出现在你自己的账户里,路径可以确认 | 可核对,能下定论 |
Claude 的官方错误体结构是 {"type": "error", "error": {"type": "…", "message": "…"}, "request_id": "req_…"},超出速率限制的 429 会带 retry-after 头。中转站对外统一成 OpenAI 兼容格式是正常的,所以错误格式只用来发现明显不一致,不用来认定上游。更多状态码含义见中转站错误码对照和 GPTZZZ 错误码文档。
抓取响应头和错误体
下面的命令适用于任何 OpenAI 兼容中转站,先发一个正常请求,再发一个不存在的模型名。变量名用 RELAY_ 前缀,避免和你已有的配置混在一起。只用测试 Key 和合成输入。
macOS / Linux(bash 或 zsh):
export RELAY_BASE_URL="https://relay.example.com/v1"
export RELAY_API_KEY="YOUR_RELAY_API_KEY"
export RELAY_MODEL="MODEL_ID_FROM_CONSOLE"

# 1) 正常请求:保存响应头和响应体
printf '{"model":"%s","messages":[{"role":"user","content":"Reply with exactly: OK"}]}' "$RELAY_MODEL" > ok.json
curl -sS -D ok.headers -o ok.body.json "$RELAY_BASE_URL/chat/completions" \
  -H "Authorization: Bearer $RELAY_API_KEY" \
  -H "Content-Type: application/json" \
  -H "X-Client-Request-Id: upstream-check-001" \
  --data-binary @ok.json

# 2) 受控错误:不存在的模型名
printf '{"model":"%s","messages":[{"role":"user","content":"ping"}]}' "no-such-model-upstream-check" > bad.json
curl -sS -D bad.headers -o bad.body.json "$RELAY_BASE_URL/chat/completions" \
  -H "Authorization: Bearer $RELAY_API_KEY" \
  -H "Content-Type: application/json" \
  --data-binary @bad.json

# 3) 看关键头、返回的模型名和错误体
grep -iE '^(x-request-id|request-id|openai-|anthropic-|x-ratelimit|retry-after|x-amzn|apim-request-id)' ok.headers bad.headers
grep -o '"model": *"[^"]*"' ok.body.json
cat bad.body.json
Windows PowerShell:
$env:RELAY_BASE_URL = "https://relay.example.com/v1"
$env:RELAY_API_KEY = "YOUR_RELAY_API_KEY"
$env:RELAY_MODEL = "MODEL_ID_FROM_CONSOLE"

# 1) 正常请求:保存响应头和响应体
@{ model = $env:RELAY_MODEL; messages = @(@{ role = "user"; content = "Reply with exactly: OK" }) } |
  ConvertTo-Json -Depth 5 | Set-Content -Encoding ascii ok.json
curl.exe -sS -D ok.headers -o ok.body.json "$env:RELAY_BASE_URL/chat/completions" `
  -H "Authorization: Bearer $env:RELAY_API_KEY" `
  -H "Content-Type: application/json" `
  -H "X-Client-Request-Id: upstream-check-001" `
  --data-binary "@ok.json"

# 2) 受控错误:不存在的模型名
@{ model = "no-such-model-upstream-check"; messages = @(@{ role = "user"; content = "ping" }) } |
  ConvertTo-Json -Depth 5 | Set-Content -Encoding ascii bad.json
curl.exe -sS -D bad.headers -o bad.body.json "$env:RELAY_BASE_URL/chat/completions" `
  -H "Authorization: Bearer $env:RELAY_API_KEY" `
  -H "Content-Type: application/json" `
  --data-binary "@bad.json"

# 3) 看关键头、返回的模型名和错误体
Select-String -Path ok.headers, bad.headers -Pattern '^(x-request-id|request-id|openai-|anthropic-|x-ratelimit|retry-after|x-amzn|apim-request-id)'
Select-String -Path ok.body.json -Pattern '"model":\s*"[^"]*"' | ForEach-Object { $_.Matches.Value }
Get-Content bad.body.json
X-Client-Request-Id 是 OpenAI API 支持的客户端自定义请求 ID,中转站不一定转发它;它的作用是让你在自己的日志里对上这次请求。检查 Claude 原生接口时,按该服务的文档换成 /v1/messages 路径和对应的鉴权头。
用价格做对照:以 GPTZZZ 的 gpt-5.5 为例
gpt-5.5 在 GPTZZZ 的分组价格(官方价 US$5.00 / $30.00,每 1M Token 输入 / 输出):opai puls 分组(页面标注“GPT 订阅号池”,0.05x)输入 ¥0.25、输出 ¥1.50,即 ¥0.05/刀;opai pro 分组(页面标注“GPT 订阅号池”,0.1x)输入 ¥0.50、输出 ¥3.00,即 ¥0.10/刀;pro200-500不降智分组(“GPT 订阅号池”,0.25x)输入 ¥1.25、输出 ¥7.50,即 ¥0.25/刀;GPT官key 分组(“官方 Key”,0.54x)输入 ¥3.91、输出 ¥23.40,即 ¥0.78/刀。充值 ¥1 = 余额 $1,“元/刀”就是官方每 1 美元用量在本站收多少元。价格以模型价格页和控制台为准。
这就是“分组名和倍率对照官方价”这项检查的用法。注意“元/刀”按充值 ¥1 = 余额 $1 计算,而厂商按美元收费;要判断能否覆盖官方按量成本,应把元/刀和 1 美元按当日汇率折合的人民币比较。按这个口径,上面四个分组(包括标为“官方 Key”的分组)都低于 OpenAI 官方按量价。本文不解释这些分组的成本来源,GPTZZZ 的分组同样适用本节的检查,也可以通过GPTZZZ 技术支持页书面询问。看到别家中转站的价格时,也先换算成同一口径再比较;倍率的复算方法见中转站倍率与请求级账单复算。
服务商可以保密什么,仍应说明什么
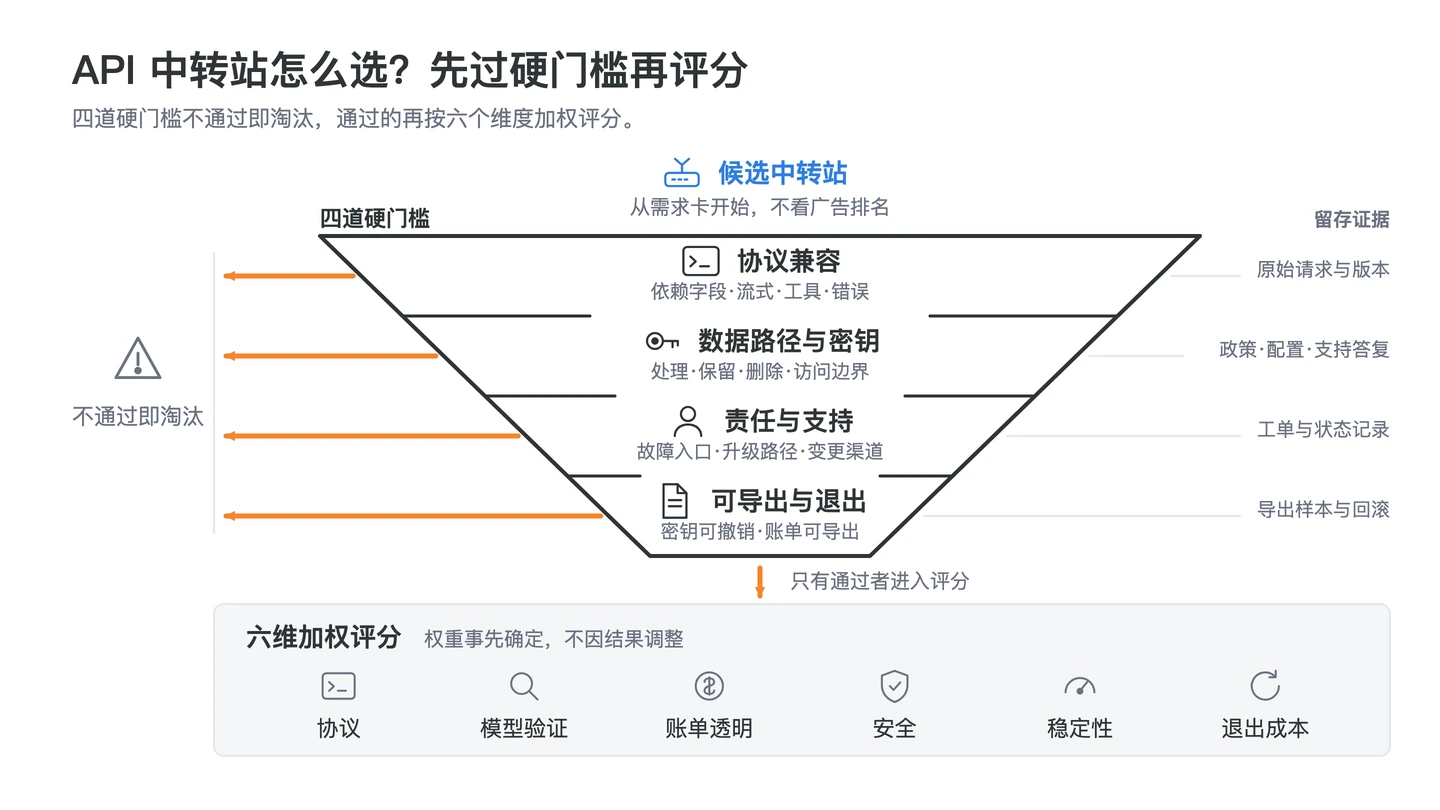
上游密钥、采购合同全文、内部拓扑和防滥用规则可以保密,公开它们反而增加安全风险。但上游类别(官转、云渠道、号池还是逆向)、模型与协议范围、数据处理主体和保留期限、限流与错误语义、重大路由变更和退出方式,应该能说清楚。透明度够不够,标准是“足以做决定”,而不是公开全部商业细节。
十分钟上游透明度核验流程
- 记录模型目录、分组类型、价格规则和页面日期。
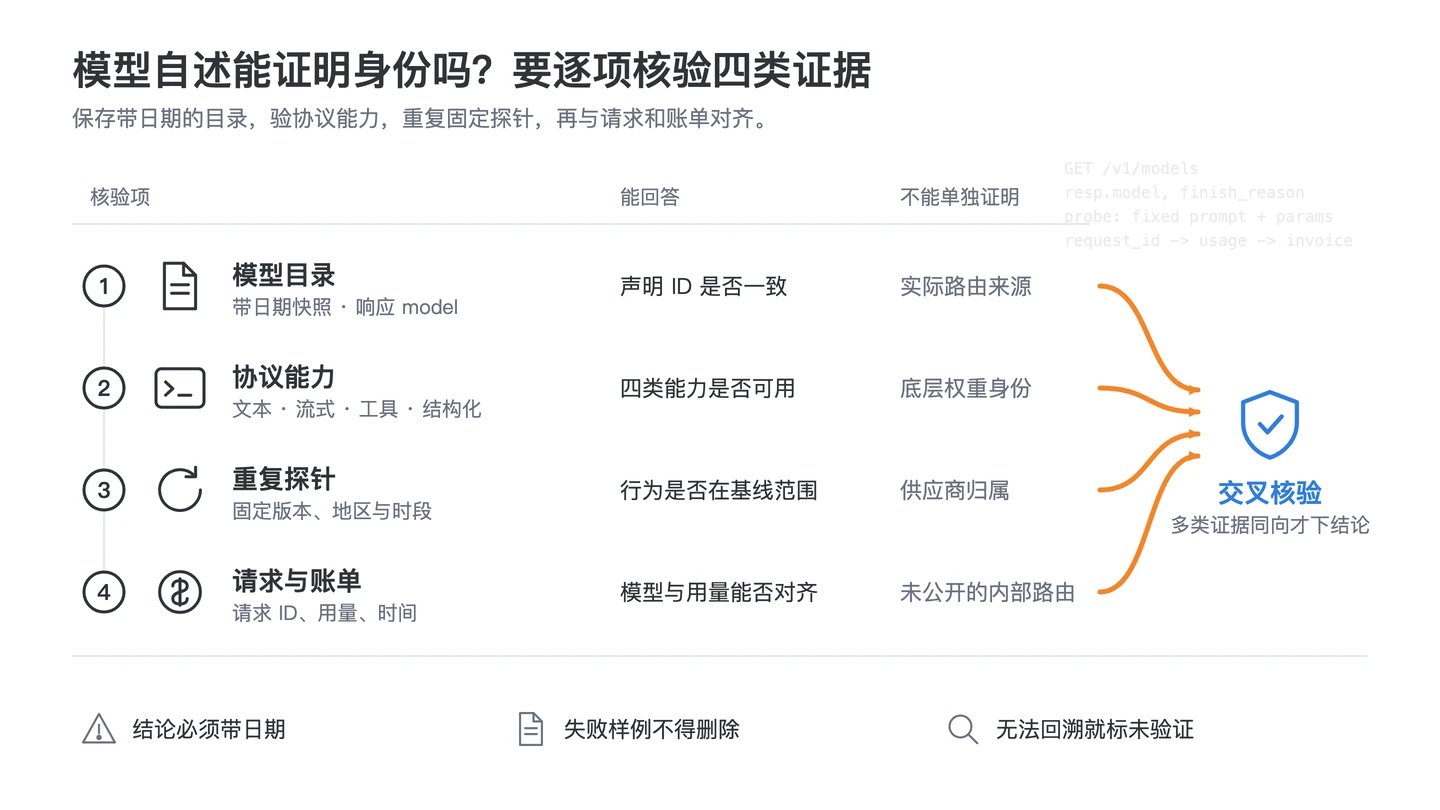
- 用隔离的测试 Key 发一个最小正常请求,保存完整响应头和 model 字段。
- 发一个不存在的模型名,保存错误体和请求 ID。
- 把客户端请求 ID、服务端请求 ID、模型、usage、账单和本地时间对上。
- 阅读数据政策、状态页、变更记录和事故通知渠道。
- 带一个具体请求 ID 联系支持,看能否定位,而不是只给模板回复。
- 把证据、未知项、测试条件和复测日期写进日志。
按证据等级做决定
| 等级 | 例子 | 用途 | 权重 |
|---|---|---|---|
| 账户级 | 自带 Key 后厂商控制台里的用量和账单 | 确认实际路径 | 最高,但需要服务支持自带 Key |
| 请求级 | 响应头、请求 ID、model、usage、错误体 | 定位单次行为 | 高,只覆盖该请求,且可被改写 |
| 产品与政策级 | 分组说明、状态页、变更记录、数据与支持条款 | 判断服务范围、分配责任 | 高,需绑定日期和适用范围 |
| 营销级 | “官方线路”“原生体验”“不降智”等措辞 | 生成待验证的问题 | 不能单独作为技术证明 |
这套流程测的是披露是否一致,看不到私有供应链全貌。行为层面的下一步见中转站模型一致性检测方法,数据路径见API 中转站数据与隐私检查。
证据冲突和路由变更怎么处理
说法和证据对不上时,先固定时间、账户、端点、客户端和输入,重放最小用例并保存原始响应头和页面版本。不要挑对自己有利的那条,也不要立刻认定对方作假。
| 冲突 | 最小复核 | 决策状态 |
|---|---|---|
| 宣称官转,但价格远低于官方按量价 | 书面询问成本来源和上游类别 | 解释前按非官转对待 |
| 目录映射与响应 model 不同 | 固定模型名重复请求,询问别名与回退规则 | 解释前不依赖固定版本能力 |
| 请求 ID 无法被支持定位 | 提交准确时间、ID 和错误类型 | 降低可追踪性评级 |
| usage 与账单模型不同 | 逐字段复算,查路由和价格版本 | 暂停扩量 |
| 数据政策与产品界面不同 | 确认展示来源、保留和删除路径 | 停止敏感数据接入 |
上游会变。先分清三种名称:固定模型 ID 指向特定版本;便捷别名映射到一个当前模型;自动路由名按规则在多个目标间选择。固定模型名要有映射版本和退役日期;自动路由要说明会影响哪些协议、能力、价格和数据处理。重大变化的通知至少包含生效时间、受影响的分组或模型、预期差异和测试窗口。收到通知后跑一遍最小回归集,结果关联到新的目录版本;事前来不及通知的故障切换,事后也应能通过状态页或事故记录查到时间窗,并能用请求 ID 查具体请求。
降低单一上游锁定风险
在应用内部使用 provider adapter 和稳定的内部模型名,把外部模型映射集中在配置层;架构方式见多模型 API 网关设计。保留第二端点和最小回归集,并按OpenAI 兼容 API 迁移与回滚记录字段差异。
- 生产关键路径不只依赖号池或逆向类上游,至少准备一条官转或云渠道备用。
- 目录或映射变化时自动触发回归,而不是静默接受。
- 密钥、配置、账单与请求证据可导出,停用步骤已演练。
- 业务级请求 ID 能展开为每次上游尝试,重试和回退不混淆。
- 冲突未解释时:暂停受影响别名,切到已验证的固定模型或第二端点,撤销旧 Key,导出证据和账单。
常见问题
API 中转站的上游是什么意思?
上游是中转站实际把请求发往的地方:厂商官方 API、云平台托管的模型、消费订阅号池,或逆向的网页端和 IDE 接口。页面上显示的模型名不等于上游。
官转、号池和逆向有什么区别?
官转用厂商按量 API Key,接口和条款风险最接近官方;号池共享 ChatGPT、Claude 等消费订阅账号,价格低,但与 OpenAI、Anthropic 消费者条款中不得分享账户凭据的规定冲突;逆向模拟网页端或 IDE 私有接口,最便宜也最不稳定。
怎么查看一个中转站用的是什么上游?
先书面询问,再把站内价格换算成官方价的比例,然后保存响应头、model 字段、错误体和限流表现做对照。这些都只是线索;只有用自带 Key 并在自己的厂商账单里看到用量,才能确认路径。
价格只有官方一两折的中转站,上游一般是什么?
先按当日汇率把官方美元价折成人民币再比较。如果确实只有一两折,按官方标价付费的 API Key 覆盖不了这个成本,常见解释是订阅号池、赠送额度或逆向额度。这是较强信号,但仍需要服务商书面说明。
订阅号池转 API 违反厂商条款吗?
OpenAI 使用条款禁止分享账户凭据、让他人使用账户和以编程方式提取输出;Anthropic 消费者条款禁止分享账户凭据,Claude Code 文档也不允许第三方通过 Free、Pro、Max 凭据代用户转发请求。使用这类渠道要自己评估账号被限导致的中断风险。
响应里的 model 字段能证明上游吗?
不能。中转方可以改写 model 字段,也可以删除或伪造响应头。官方特有的头和 ID 格式只能算线索,没有出现也说明不了问题。
服务商不公开上游合同还能评估吗?
可以评估披露是否足以决策。合同全文和安全敏感细节可保密,但上游类别、模型范围、数据处理、用量、错误、重大变更和支持责任仍应说明。
怎样避免业务系统被单一 API 上游锁定?
使用内部适配器和稳定模型名,集中外部映射,保留第二端点与最小回归集,并定期演练配置导出、密钥撤销和限时回滚。
一手来源与核验日期
- OpenAI 使用条款(2026-01-01 生效)(核验于 2026-10-09)
- Anthropic Consumer Terms of Service(核验于 2026-10-09)
- Claude Code:Legal and compliance(认证与凭据使用)(核验于 2026-10-09)
- Kiro 定价与订阅使用范围(核验于 2026-10-09)
- Amazon Bedrock:Models at a glance(核验于 2026-10-09)
- Gemini Enterprise Agent Platform 发布说明(Vertex AI 并入)(核验于 2026-10-09)
- Gemini Enterprise Agent Platform:Google、合作与开放模型列表(核验于 2026-10-09)
- Amazon Bedrock InvokeModel API(X-Amzn-Bedrock-* 响应头)(核验于 2026-10-09)
- Claude on Google Cloud(核验于 2026-10-09)
- Microsoft Foundry:Foundry Models sold by Azure(核验于 2026-10-09)
- Claude in Microsoft Foundry(核验于 2026-10-09)
- OpenAI API Pricing(gpt-5.5 按量价)(核验于 2026-10-09)
- OpenAI API:Debugging requests(响应头与 X-Client-Request-Id)(核验于 2026-10-09)
- Claude API errors 与 request ID(核验于 2026-10-09)
- Claude API rate limits 与响应头(核验于 2026-10-09)
这些来源用于界定条款、云平台模型范围、响应头和错误格式;本文不把当前模型、价格和条款写成永久事实。
本文的厂商条款、云平台模型范围和响应头说明核验于 2026-10-09;GPTZZZ 分组与价格取自同日的模型价格页。模型、价格、条款和路由都会变,上线前请按当前文档和你自己的请求记录重新验证。