OpenAI API Key 怎么获取:官方渠道与兼容网关的取舍
搜「OpenAI API Key 购买」的人通常卡在两个地方之一:分不清会员和 API 是两套计费,或者具备条件但支付过不去。这两件事的解法完全不同,先分清楚再往下看。
先确认你要的是不是 API
这是最常见的误解,也是退款纠纷的高发点。两者的账户体系相通,额度完全独立。
| ChatGPT 会员 | OpenAI API | |
|---|---|---|
| 用在哪 | 网页和 App 的对话界面 | 你自己的代码里 |
| 怎么计费 | 按月订阅 | 按调用量,预充值 |
| 买了会员有 API 额度吗 | 没有 | — |
| 买了 API 额度能用网页版吗 | — | 不能 |
如果你要的是在网页里对话,买 API Key 没有用;要在代码里调用,买会员也没有用。下单前先回答这一个问题,后面的内容才有意义。
中转、网关、代充这些概念的区别,以及各自解决什么问题,见API 中转站是什么。
官方渠道需要什么
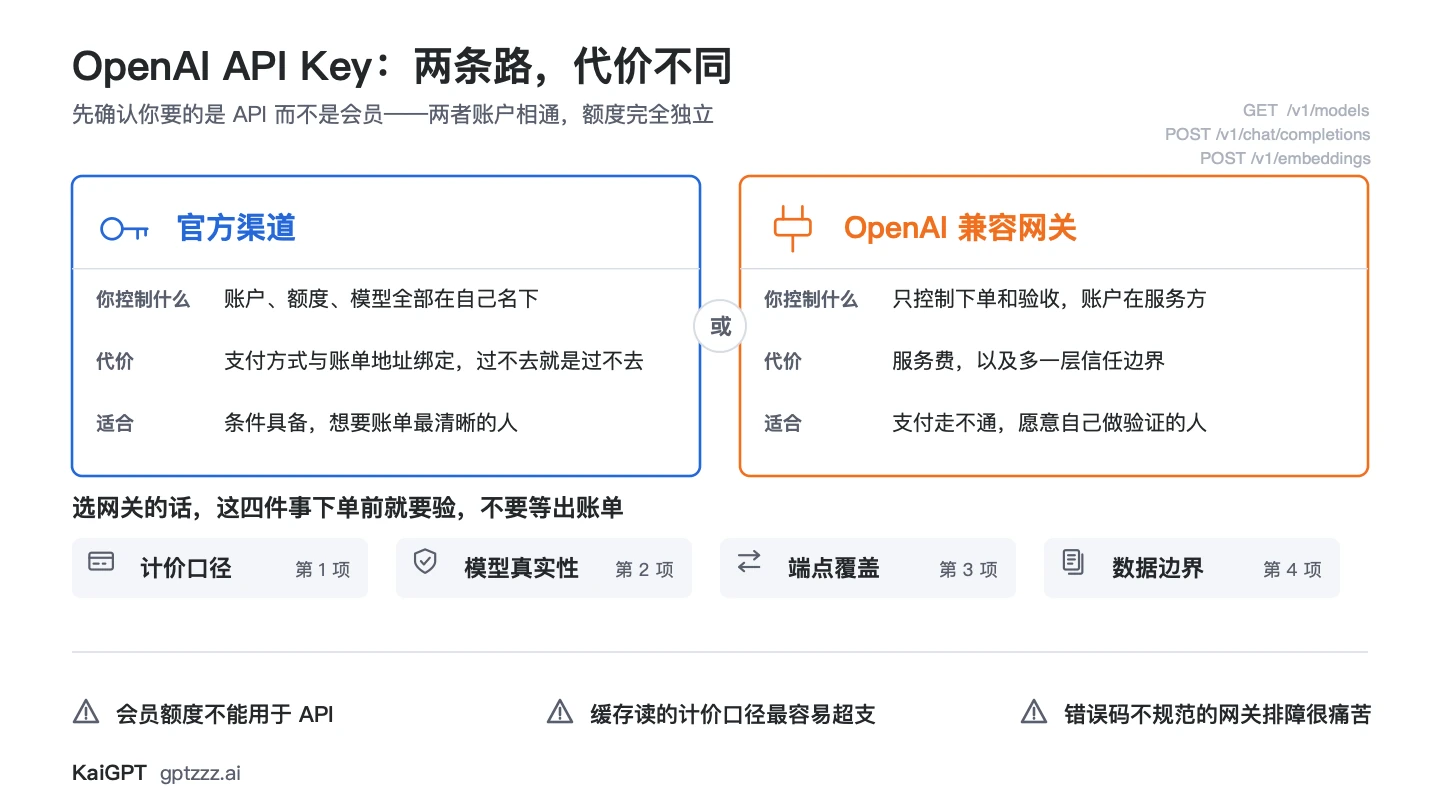
官方 API 的账单由 Stripe 处理,可用的支付方式与账单地址、发卡行所在地绑定。条件具备的话,官方是最直接的选择:账单清晰、模型确定、没有中间环节。
流程是在 OpenAI 平台创建账户、绑定支付方式、预充值,然后在控制台创建 API Key。
拿到 Key 之后有几点值得立刻处理:
- Key 只在创建时显示一次,之后无法再查看,只能重新生成——当场存进密码管理器
- 按项目分 Key,出问题时可以单独吊销,不影响其他服务
- 设置用量上限,避免代码缺陷导致的意外消耗,比如一个写错的循环
- 不要把 Key 写进前端代码或提交到仓库,一旦泄露应立即吊销,而不是先查有没有被用过
密钥的存放、轮换与泄露处置,见API 密钥安全。
支付过不去时的选择
支付校验通不过时,市面上有几类替代方案,各有代价。代价的核心差别在于「你还控制多少」。
| 方案 | 你控制什么 | 主要代价 |
|---|---|---|
| 虚拟信用卡 | 自己开卡、自己绑、自己充值,账户还是你的 | 开卡费和充值手续费,卡段可能被拒 |
| OpenAI 兼容网关 | 下单和验收,账户在服务方 | 服务费,以及多一层信任边界 |
| 购买他人账户 | 几乎不控制 | 账户随时可能被找回,不建议 |
第三类本文不展开,理由和购买成品会员账号一样:你拿到的是一个自己不拥有的账户。原始持有者随时可以通过找回流程把它要回去,而你没有任何凭据。
前两类是真实可选项。选第一类,你的验证工作是零——账户是官方的;选第二类,验证工作全在你自己身上,下一节讲要验什么。
用兼容网关时,必须核对的四件事
如果选择兼容网关,下面四项在下单前就要问清楚,不要等出账单才发现。
第一,计价口径
至少要能查到三样东西:单次请求的 token 用量(分输入、输出、缓存读、缓存写)、该次的计费金额、可导出的历史明细。三者缺一就无法核对账单——你只能接受它报给你的数字。
特别注意缓存读的计价。长上下文场景里缓存读的 token 量可能是输入的数倍,口径不清楚会让账单显著超出预期。同一份账单,按输入价算和按缓存读价算能差出好几倍。
倍率、缓存计价与结算口径的完整说明,见中转站倍率与计费口径。
第二,模型真实性
模型 ID 是网关自己填的字符串,写什么都行。确认背后是不是你以为的模型,有两个可操作的办法:
看返回的 usage 结构是否匹配该代次模型,比如是否有 reasoning tokens 字段;以及故意发送一个不支持的参数值,看上游报错里会不会暴露真实模型名——转发层通常原样透传上游的错误文本。
更多验证手法见怎么验证中转站的模型是不是真的。
第三,端点与协议覆盖
确认它支持你实际要用的端点,而不是只支持最常见的那一个。常见的差异:
| 端点 | 用途 | 是否常见缺失 |
|---|---|---|
/v1/chat/completions | 对话补全 | 基本都有 |
/v1/responses | 新版响应接口 | 部分缺失 |
/v1/embeddings | 向量嵌入 | 经常没有 |
/v1/messages | Anthropic 协议 | 按模型和分组不同 |
| 图片输入(URL 形式) | 多模态 | 上游拉取常失败,base64 更可靠 |
最后两行值得留意。/v1/messages 的可用性常常是按分组开的,同一家的两个套餐结果可能不一样;而图片传 URL 需要上游主动去拉那个地址,失败率明显高于直接传 base64。
下单前用最小请求逐个试一遍,比看宣传页可靠。
第四,数据边界
网关在技术上能看到你发送的全部内容——包括你贴进去的代码和文档。确认四件事:是否记录请求正文、记录多久、是否用于训练、上游是官方还是另一层中转。
多层中转意味着更多不受控环节,排障也更难:出问题时你不知道是哪一层的问题,而你只能联系到最外面那一层。数据边界的完整核对方法见中转站的数据安全与隐私边界。
一个下单前的最小验证流程
不要相信宣传页,用五条命令自己验。全部能跑通再付钱。
BASE="https://你的网关/v1"; KEY="你的密钥"

# 1. 模型列表是否可查
curl -s "$BASE/models" -H "Authorization: Bearer $KEY" | head -c 400

# 2. 最小对话
curl -s "$BASE/chat/completions" -H "Authorization: Bearer $KEY" \
  -H "content-type: application/json" \
  -d '{"model":"你的模型ID","messages":[{"role":"user","content":"hi"}],"max_tokens":16}'

# 3. 流式
curl -sN "$BASE/chat/completions" -H "Authorization: Bearer $KEY" \
  -H "content-type: application/json" \
  -d '{"model":"你的模型ID","messages":[{"role":"user","content":"数到三"}],"max_tokens":32,"stream":true}' | tail -3

# 4. 工具调用
curl -s "$BASE/chat/completions" -H "Authorization: Bearer $KEY" \
  -H "content-type: application/json" \
  -d '{"model":"你的模型ID","messages":[{"role":"user","content":"北京天气"}],
       "tools":[{"type":"function","function":{"name":"get_weather","parameters":{"type":"object","properties":{"city":{"type":"string"}}}}}],"max_tokens":64}'

# 5. 错误行为
curl -s "$BASE/chat/completions" -H "Authorization: Bearer 错误的密钥" \
-H "content-type: application/json" -d '{"model":"x","messages":[]}'| 步骤 | 通过标准 |
|---|---|
| 1 | 返回模型数组,且包含你要用的 ID |
| 2 | 200,返回结构与 OpenAI 一致 |
| 3 | SSE 分块正常,以 [DONE] 结束 |
| 4 | finish_reason 为 tool_calls |
| 5 | 返回 401,错误结构为标准的 {"error":{"message","type"}} |
第五步常被忽略,但它反映的是这个网关对错误的处理是否规范。 把 401 转成 500、或者返回非标准结构的,接入后排障会很痛苦——你的客户端库按 OpenAI 的规范解析错误,遇到自定义结构就只能给你一个「未知错误」。
更完整的验证脚本和判断标准,见中转站实测方法。
常见问题
官方 Key 和网关 Key 能混用吗?
不能。两者是不同账户体系下的凭据。切换时需要同时改 Base URL 和 Key,只改一个会报 401 或 404。
怎么判断一家网关是不是多层中转?
看固定延迟和错误格式。多一层通常多 200 毫秒以上的固定开销;错误信息被包了两层、格式不是上游原生的,也是信号。
额度会过期吗?
官方和各网关的规则不同,有的按自然月清零,有的长期有效。下单前直接问,并留存书面答复——这一项事后很难说清。
为什么 /v1/embeddings 经常没有?
嵌入模型和对话模型是分开计费和分开采购的,很多网关只接了对话模型。如果你要做知识库或检索,这一项必须在下单前确认,事后加不了。
继续阅读
中转站实测方法:下单前该跑哪几条命令
用最小请求逐项验证模型、流式、工具调用与错误行为,把宣传页换成自己测出来的结果。
中转站倍率与计费口径
倍率怎么算、缓存读写如何计价,以及账单对不上时该查哪几个字段。