GPT Image 2 中转接入:按张计费、参数差异与验收方法
把图像模型当成文本模型来接,账单和行为都会出乎意料。图像按张计费而非按 token,倍率规则常常与文本分开,参数支持也各家不一。这几项都要单独验一遍——本文用一次实测把差异逐条摆出来。
一次实测:四项和文本模型不一样的行为
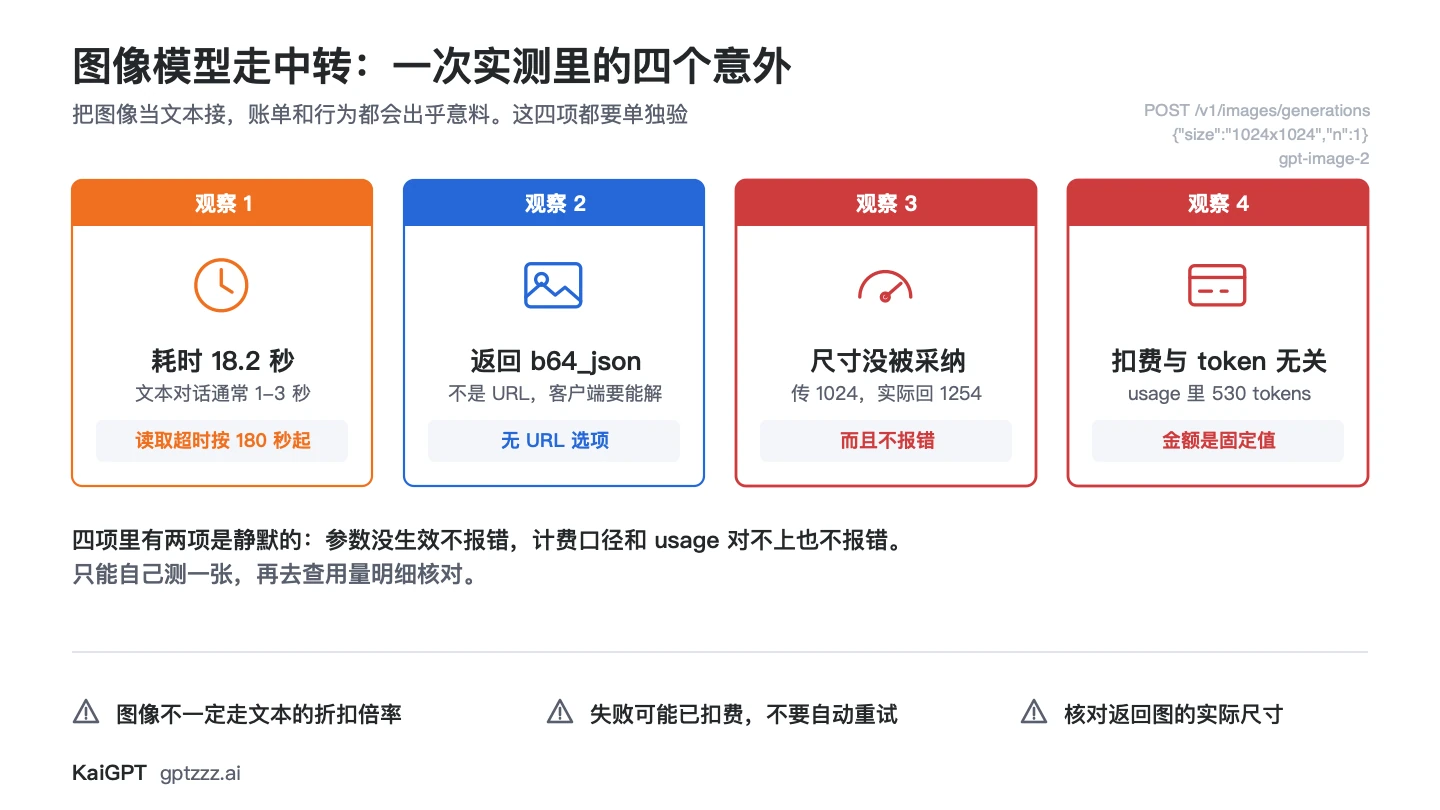
为了写这篇,我们对一个 OpenAI 兼容网关发了一次最小的图像生成请求:gpt-image-2,n=1,请求尺寸 1024x1024。
四项观察,每一项都和文本模型的直觉相反:
| 观察 | 结果 | 含义 |
|---|---|---|
| 耗时 | 18.2 秒 | 文本对话通常 1-3 秒,沿用文本超时会大量误报失败 |
| 返回格式 | b64_json,没有 URL 选项 | 客户端要能直接解 base64,不能假设拿到的是链接 |
| 尺寸参数 | 请求 1024x1024,实际返回 1254x1254 | 参数没有被采纳,而且没有报错 |
| 计费 | 金额是一个固定值,与 usage 里的 token 数算不出换算关系 | token 统计只是统计,不是计费依据 |
这次返回的 usage 是这样的:
{
  "input_tokens": 15,
  "input_tokens_details": { "image_tokens": 0, "text_tokens": 15 },
  "output_tokens": 515,
  "output_tokens_details": { "image_tokens": 515, "text_tokens": 0 },
  "total_tokens": 530
}结构完整,字段齐全,看起来完全可以拿来算钱。但实际扣费金额按任何合理单价都算不出这 530 个 token——差了一个数量级。这是本文最重要的一条:图像的 usage 和图像的账单,是两回事。
另外,同一个账户下文本调用的实际扣费是标价的一个折扣倍数,而这次图像调用的两个金额字段完全相等。折扣倍率没有应用到图像上。
最大的差异:计费单位不是 token
文本模型按输入输出 token 计费,图像模型通常按生成的张数计费,与提示词长度关系很小。写一句话的提示词和写三百字的提示词,出一张图的价格基本一样。
这带来两个后果。
第一,倍率可能不适用。 很多网关对文本模型给折扣倍率,图像模型却按原价结算。下单前要单独问图像模型的计价,不要假设和文本一样——上面那次实测正是这种情况。
第二,用量页面的 token 数没有参考价值。 核对账单时应当看金额和张数,而不是 token 数。如果你写了一个按 token 估算成本的脚本,它在图像请求上会给出错得离谱的数字。
倍率与结算口径的通用说明见中转站倍率与计费口径;把成本纳入日常监控的做法见AI API 成本控制。
必须单独验证的四项
文本能跑通不代表图像能跑通。这四项要分开测。
| 验证项 | 为什么单独测 |
|---|---|
| 端点是否开放 | 图像生成常是独立端点或独立分组,可能根本没开 |
| 返回格式 | 有的返回 URL,有的返回 base64,客户端处理方式不同 |
| 尺寸与质量参数 | 支持的取值各家不同,传不支持的值可能静默降级或直接忽略 |
| 并发与超时 | 图像生成耗时远长于文本,默认超时常常不够 |
第三项的「静默」值得警惕:你请求了某个尺寸,它按另一个尺寸生成,不报错。上面那次实测就是这样——传 1024,回 1254,HTTP 200。
发现的办法是核对返回图像的实际尺寸,而不是相信请求参数。返回体里通常有 size 字段,或者直接读解码后的图片头。如果你的产品对尺寸有硬要求(比如要贴进固定版式),这一步必须做。
质量参数同理:请求高质量、按低质量生成并按低质量计费而不报错,是可能发生的。
超时要单独设
图像生成的耗时通常在十几秒到一分钟量级。上面那次最简单的请求就用了 18.2 秒——那还只是「白底红圆」这种最简单的提示词。沿用文本的超时设置会大量误报失败。
| 参数 | 文本对话 | 图像生成 |
|---|---|---|
| 连接超时 | 10 秒 | 10 秒 |
| 读取超时 | 60 秒 | 180 秒起 |
| 重试 | 可重试 | 谨慎,失败的请求可能已产生计费 |
重试这一条要特别注意。如果一次图像请求实际已在上游生成成功但响应超时,重试会再生成一次,两次都计费。图像单价远高于文本,重复计费的代价更明显——文本重试一次多花的是零头,图像重试一次多花的是一整张的钱。
安全做法是:图像请求不自动重试,失败后先查用量明细确认是否已扣费,再决定是否重发。这属于「有副作用的调用不能盲目重试」的一种,完整判断标准见中转站重试与故障回退。
验收流程
三条命令,下单前跑一遍。
BASE="https://你的网关/v1"; KEY="你的密钥"

# 1. 确认模型在列表里
curl -s "$BASE/models" -H "Authorization: Bearer $KEY" \
  | grep -o '"id":"[^"]*image[^"]*"'

# 2. 最小生成请求,注意超时设长
curl -s --max-time 180 "$BASE/images/generations" \
  -H "Authorization: Bearer $KEY" -H "content-type: application/json" \
  -d '{"model":"你的图像模型ID","prompt":"a red circle on white background","n":1,"size":"1024x1024"}'

# 3. 立刻查用量,确认扣了多少
curl -s "$BASE/usage" -H "Authorization: Bearer $KEY"第三步是关键。生成成功后马上查用量,记下这一张扣了多少钱、计价单位是什么。这个数字才是你做预算的依据,宣传页上的倍率不是。
做第二步时,别忘了把返回体里的 size 和你请求的值比一下。
| 步骤 | 通过标准 |
|---|---|
| 1 | 模型 ID 出现在列表中 |
| 2 | 返回图像数据或 URL,180 秒内完成,且返回尺寸与请求一致 |
| 3 | 用量记录出现,金额和张数对得上 |
文本端点的对应验收流程见中转站实测方法;如果你要在一个网关上同时用文本和图像模型,还要确认它们是不是同一个分组,见多模型 API 网关。
图像输入的一个坑
如果你要做图生图或让模型分析图片,注意图片输入的传递方式。两种选择:传 URL 让上游去拉,或者转成 base64 直接嵌在请求里。
实测中,走网关时 URL 方式经常失败,上游拉取会返回错误。原因可能是上游的出网限制、URL 本身的可达性、或者网关没有正确透传。报错信息通常只说下载失败,不会告诉你是哪一层的问题。
base64 方式更可靠,代价是请求体变大。多数客户端库默认就用 base64,所以这个坑更容易在你手写 HTTP 请求时踩到。
如果你遇到「传图片报错但纯文本正常」,先换成 base64 试一次,大概率能解决。
常见问题
图像模型的倍率和文本一样吗?
不一定,很多情况下不一样。我们实测的那次,文本调用的实际扣费是标价的一个折扣倍数,而图像调用的标价和实际扣费完全相等,也就是折扣没应用到图像上。必须单独问,并用验收流程实测一张确认。
生成失败了会扣费吗?
取决于失败发生在哪一段。请求没到上游不会扣,上游生成了但传输失败通常会扣。这也是不建议自动重试的原因。查用量明细是唯一可靠的确认方式。
怎么控制图像的成本?
三条:单独给图像设用量上限;不自动重试;生成前先用小尺寸低质量试一次提示词效果,满意再出高质量版本。
为什么请求的尺寸和返回的尺寸对不上?
网关或上游可能忽略了 size 参数,按自己的默认值生成,并且不报错。实测中我们请求 1024x1024,返回的是 1254x1254。判断办法是读返回体里的 size 字段,不要相信请求参数。
usage 里有 token 数,为什么不能用来算钱?
图像按张计费,usage 里的 token 统计和实际扣费金额之间没有换算关系。我们实测那次返回 530 tokens,按任何合理单价都算不出实际扣费金额,差一个数量级。核对账单要看金额和张数。
继续阅读
中转站倍率与计费口径
倍率怎么算、缓存读写如何计价,以及账单对不上时该查哪几个字段。
AI API 成本控制
把用量、单价与上限纳入日常监控,在账单出来之前发现异常消耗。